# LeViT
## Resumen
El modelo LeViT se propuso en [LeViT: Introducing Convolutions to Vision Transformers](https://huggingface.co/papers/2104.01136) de Ben Graham, Alaaeldin El-Nouby, Hugo Touvron, Pierre Stock, Armand Joulin, Hervé Jégou, Matthijs Douze. LeViT mejora el [Vision Transformer (ViT)](vit) en rendimiento y eficiencia mediante algunas diferencias arquitectónicas, como mapas de activación con resoluciones decrecientes en Transformers y la introducción de un sesgo de atención para integrar información posicional.
El resumen del artículo es el siguiente:
*Diseñamos una familia de arquitecturas de clasificación de imágenes que optimiza el equilibrio entre precisión y eficiencia en un régimen de alta velocidad. Nuestro trabajo aprovecha los hallazgos recientes en arquitecturas basadas en atención, que son competitivas en hardware de procesamiento altamente paralelo. Revisamos principios de la extensa literatura sobre redes neuronales convolucionales para aplicarlos a los transformers, en particular mapas de activación con resoluciones decrecientes. También introducimos el sesgo de atención, una nueva forma de integrar información posicional en los transformers de visión. Como resultado, proponemos LeVIT: una red neuronal híbrida para la clasificación de imágenes con inferencia rápida. Consideramos diferentes medidas de eficiencia en distintas plataformas de hardware, a fin de reflejar mejor una amplia gama de escenarios de aplicación. Nuestros experimentos extensos validan empíricamente nuestras elecciones técnicas y demuestran que son adecuadas para la mayoría de las arquitecturas. En general, LeViT supera significativamente a las convnets y los transformers de visión existentes en cuanto al equilibrio entre velocidad y precisión. Por ejemplo, con una precisión top-1 del 80% en ImageNet, LeViT es 5 veces más rápido que EfficientNet en CPU.*
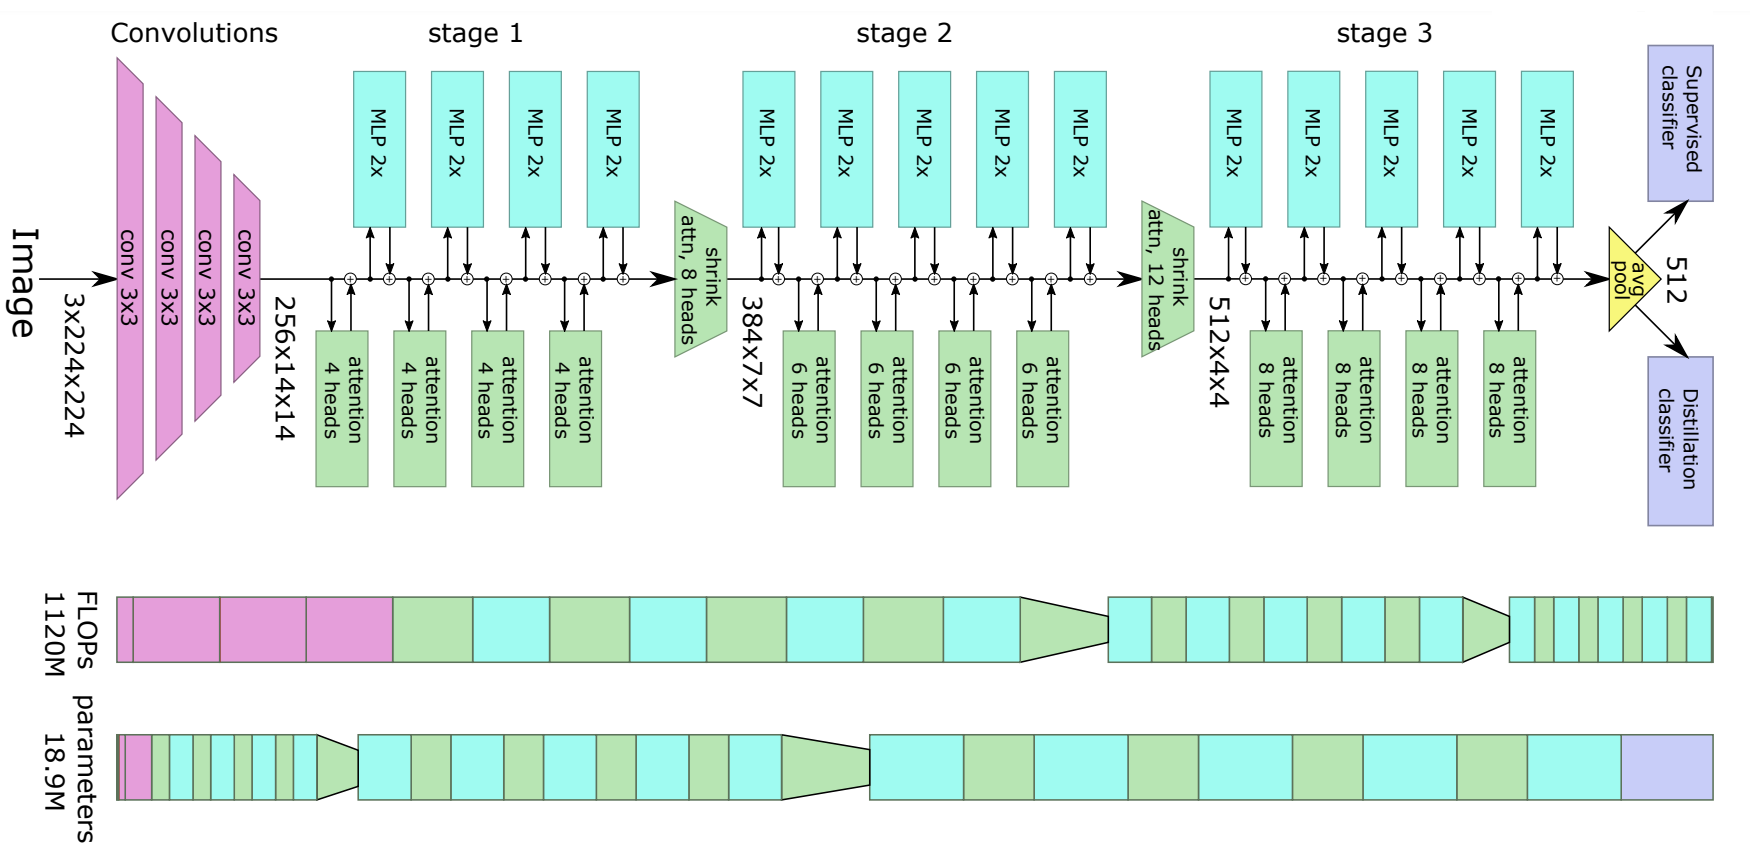 Arquitectura de LeViT. Tomada del artículo original.
Este modelo fue aportado por [anugunj](https://huggingface.co/anugunj). El código original se puede encontrar [aquí](https://github.com/facebookresearch/LeViT).
## Consejos de uso
- En comparación con ViT, los modelos LeViT utilizan una cabeza de destilación adicional para aprender eficazmente de un modelo maestro (que, en el artículo de LeViT, es un modelo similar a ResNet). La cabeza de destilación se aprende mediante retropropagación bajo la supervisión de un modelo similar a ResNet. También se inspiran en las redes neuronales convolucionales para utilizar mapas de activación con resoluciones decrecientes y así aumentar la eficiencia.
- Existen 2 formas de realizar el ajuste fino de modelos destilados: (1) de manera clásica, colocando únicamente una cabeza de predicción sobre el estado oculto final y sin utilizar la cabeza de destilación, o (2) colocando tanto una cabeza de predicción como una cabeza de destilación sobre el estado oculto final. En ese caso, la cabeza de predicción se entrena mediante la entropía cruzada regular entre la predicción de la cabeza y la etiqueta correcta, mientras que la cabeza de predicción de destilación se entrena mediante destilación dura (entropía cruzada entre la predicción de la cabeza de destilación y la etiqueta predicha por el modelo maestro). En el momento de la inferencia, se toma la predicción promedio entre ambas cabezas como predicción final. (2) también se denomina "ajuste fino con destilación", ya que se depende de un modelo maestro que ya ha sido ajustado en el conjunto de datos de destino. En términos de modelos, (1) corresponde a [LevitForImageClassification](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassification) y (2) corresponde a [LevitForImageClassificationWithTeacher](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassificationWithTeacher).
- Todos los puntos de control publicados se preentrenaron y afinaron únicamente en [ImageNet-1k](https://huggingface.co/datasets/ILSVRC/imagenet-1k) (también conocido como ILSVRC 2012, una colección de 1,3 millones de imágenes y 1.000 clases). No se utilizó ningún dato externo. Esto contrasta con el modelo ViT original, que utilizó datos externos como el conjunto de datos JFT-300M/Imagenet-21k para el preentrenamiento.
- Los autores de LeViT publicaron 5 modelos LeViT entrenados, que pueden integrarse directamente en [LevitModel](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitModel) o [LevitForImageClassification](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassification). Se utilizaron técnicas como la aumentación de datos, la optimización y la regularización para simular el entrenamiento en un conjunto de datos mucho mayor (aunque solo se utilizó ImageNet-1k para el preentrenamiento). Las 5 variantes disponibles son (todas entrenadas con imágenes de tamaño 224x224): *facebook/levit-128S*, *facebook/levit-128*, *facebook/levit-192*, *facebook/levit-256* y *facebook/levit-384*. Tenga en cuenta que debe utilizar [LevitImageProcessor](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitImageProcessor) para preparar las imágenes para el modelo.
- [LevitForImageClassificationWithTeacher](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) actualmente solo admite inferencia, no entrenamiento ni ajuste fino.
- Puedes consultar los cuadernos de demostración sobre inferencia y ajuste fino con datos personalizados [aquí](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) (solo tienes que reemplazar [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) por [LevitImageProcessor](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitImageProcessor) y [ViTForImageClassification](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTForImageClassification) por [LevitForImageClassification](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassification) o [LevitForImageClassificationWithTeacher](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassificationWithTeacher)).
## Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados por 🌎) para ayudarte a empezar con LeViT.
- [LevitForImageClassification](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassification) es compatible con este [cuaderno](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Véase también: [Guía de la tarea de clasificación de imágenes](../tasks/image_classification)
Si te interesa enviar un recurso para que se incluya aquí, no dudes en abrir una Pull Request y lo revisaremos. Lo ideal es que el recurso demuestre algo nuevo en lugar de duplicar un recurso existente.
## LevitConfig[[transformers.LevitConfig]]
#### transformers.LevitConfig[[transformers.LevitConfig]]
```python
transformers.LevitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 224, num_channels: int = 3, kernel_size: int = 3, stride: int = 2, padding: int = 1, patch_size: int | list[int] | tuple[int, int] = 16, hidden_sizes: list[int] | tuple[int, ...] = (128, 256, 384), num_attention_heads: list[int] | tuple[int, ...] = (4, 8, 12), depths: list[int] | tuple[int, ...] = (4, 4, 4), key_dim: list[int] | tuple[int, ...] = (16, 16, 16), drop_path_rate: int = 0, mlp_ratio: list[int] | tuple[int, ...] = (2, 2, 2), attention_ratio: list[int] | tuple[int, ...] = (2, 2, 2), initializer_range: float = 0.02)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/configuration_levit.py#L24)
**Parámetros:**
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `224`) : El tamaño (resolución) de cada imagen.
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
kernel_size (`int`, *opcional*, valor predeterminado `3`) : El tamaño del kernel de convolución.
stride (`int`, *opcional*, valor predeterminado 2) : El tamaño del paso para las capas de convolución iniciales de la incrustación de parches.
padding (`int`, *opcional*, valor predeterminado 1) : El tamaño de relleno para las capas de convolución iniciales de la incrustación de parches.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `16`) : El tamaño (resolución) de cada parche.
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *opcional*, valor predeterminado `(128, 256, 384)`) : Dimensionalidad (tamaño oculto) en cada etapa del modelo.
num_attention_heads (`Union[list[int], tuple[int, ...]]`, *opcional*, valor predeterminado `(4, 8, 12)`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
depths (`Union[list[int], tuple[int, ...]]`, *opcional*, valor predeterminado `(4, 4, 4)`) : Profundidad de cada capa en el Transformer.
key_dim (`list[int]`, *opcional*, valor predeterminado `[16, 16, 16]`) : El tamaño de la clave en cada uno de los bloques del codificador.
drop_path_rate (`int`, *opcional*, valor predeterminado `0`) : Tasa de drop path para la fusión de parches.
mlp_ratio (`Union[list[int], tuple[int, ...]]`, *opcional*, valor predeterminado `(2, 2, 2)`) : Proporción entre la dimensión oculta del MLP y la dimensión de incrustación.
attention_ratio (`list[int]`, *opcional*, valor predeterminado `[2, 2, 2]`) : Proporción del tamaño de la dimensión de salida con respecto a la dimensión de entrada de las capas de atención.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
Esta es la clase de configuración para almacenar la configuración de un LevitModel. Se utiliza para instanciar un modelo Levit según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [facebook/levit-128S](https://huggingface.co/facebook/levit-128S)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import LevitConfig, LevitModel
>>> # Initializing a LeViT levit-128S style configuration
>>> configuration = LevitConfig()
>>> # Initializing a model (with random weights) from the levit-128S style configuration
>>> model = LevitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LevitImageProcessor[[transformers.LevitImageProcessor]]
#### transformers.LevitImageProcessor[[transformers.LevitImageProcessor]]
```python
transformers.LevitImageProcessor(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/image_processing_levit.py#L33)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, valor predeterminado `None`) : Indica si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 224}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `False`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando size es un int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'height' : 224, 'width': 224}`): Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `3`) : Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.485, 0.456, 0.406]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.229, 0.224, 0.225]`) : Desviación estándar de la imagen que se utilizará para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
Construye un procesador de imágenes LevitImageProcessor.
#### preprocess[[transformers.LevitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Bandera para desarrolladores destinada a entradas adicionales similares a imágenes que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo, `preprocess(images, masks=masks)` es la opción preferida, pero puede provocar problemas de prioridad de argumentos en algunos modelos. En esos casos, se puede usar `preprocess(images, image_like_inputs={"masks": masks})` en su lugar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
## LevitImageProcessorPil[[transformers.LevitImageProcessorPil]]
#### transformers.LevitImageProcessorPil[[transformers.LevitImageProcessorPil]]
```python
transformers.LevitImageProcessorPil(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/image_processing_pil_levit.py#L32)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, valor predeterminado `None`) : Indica si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 224}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `False`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando size es un int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'height' : 224, 'width': 224}`): Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `3`) : Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.485, 0.456, 0.406]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.229, 0.224, 0.225]`) : Desviación estándar de la imagen que se utilizará para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
Construye un procesador de imágenes LevitImageProcessor.
#### preprocess[[transformers.LevitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Bandera para desarrolladores destinada a entradas adicionales similares a imágenes que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo, `preprocess(images, masks=masks)` es la opción preferida, pero puede provocar problemas de prioridad de argumentos en algunos modelos. En esos casos, se puede usar `preprocess(images, image_like_inputs={"masks": masks})` en su lugar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
## LevitModel[[transformers.LevitModel]]
#### transformers.LevitModel[[transformers.LevitModel]]
```python
transformers.LevitModel(config: LevitConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/modeling_levit.py#L489)
**Parámetros:**
config ([LevitConfig](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Levit básico que genera estados ocultos sin ningún cabezal específico en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.LevitModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/modeling_levit.py#L498)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [LevitImageProcessor](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitImageProcessor). Consulte [LevitImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles (`processor_class` usa [LevitImageProcessor](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitImageProcessor) para procesar las imágenes).
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** `BaseModelOutputWithPoolingAndNoAttention` o `tuple(torch.Tensor)`
Un `BaseModelOutputWithPoolingAndNoAttention` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([LevitConfig](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitConfig)) y las entradas.
El método forward de [LevitModel](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_channels, height, width)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa después de una operación de agrupación en las dimensiones espaciales.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, devuelto cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, num_channels, height, width)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
Ejemplo:
```python
```
## LevitForImageClassification[[transformers.LevitForImageClassification]]
#### transformers.LevitForImageClassification[[transformers.LevitForImageClassification]]
```python
transformers.LevitForImageClassification(config: LevitConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/modeling_levit.py#L542)
**Parámetros:**
config ([LevitConfig](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo Levit con una cabeza de clasificación de imágenes en la parte superior (una capa lineal sobre las características agrupadas), por ejemplo, para ImageNet.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.LevitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/modeling_levit.py#L559)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [LevitImageProcessor](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitImageProcessor). Consulte [LevitImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles (`processor_class` usa [LevitImageProcessor](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitImageProcessor) para procesar las imágenes).
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para calcular la pérdida de clasificación/regresión de imagen. Los índices deben estar en `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1` se calcula una pérdida de regresión (pérdida de error cuadrático medio), si `config.num_labels > 1` se calcula una pérdida de clasificación (entropía cruzada).
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [ImageClassifierOutputWithNoAttention](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) o `tuple(torch.Tensor)`
Un [ImageClassifierOutputWithNoAttention](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([LevitConfig](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitConfig)) y las entradas.
El método forward de [LevitForImageClassification](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassification) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de clasificación (o de regresión si config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de clasificación (o de regresión si config.num_labels==1) (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, devuelto cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada etapa) de forma `(batch_size, num_channels, height, width)`. Estados ocultos (también llamados mapas de características) del modelo en la salida de cada etapa.
Ejemplo:
```python
>>> from transformers import AutoImageProcessor, LevitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/levit-128S")
>>> model = LevitForImageClassification.from_pretrained("facebook/levit-128S")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## LevitForImageClassificationWithTeacher[[transformers.LevitForImageClassificationWithTeacher]]
#### transformers.LevitForImageClassificationWithTeacher[[transformers.LevitForImageClassificationWithTeacher]]
```python
transformers.LevitForImageClassificationWithTeacher(config: LevitConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/modeling_levit.py#L599)
**Parámetros:**
config ([LevitConfig](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo transformer LeViT con cabezas de clasificación de imágenes en la parte superior (una capa lineal sobre el estado oculto final y una capa lineal sobre el estado oculto final del token de destilación), por ejemplo, para ImageNet. .. warning:: Este modelo solo admite inferencia. El ajuste fino con destilación (es decir, con un modelo maestro) aún no está admitido.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.LevitForImageClassificationWithTeacher.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/levit/modeling_levit.py#L621)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [LevitImageProcessor](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitImageProcessor). Consulte [LevitImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles (`processor_class` usa [LevitImageProcessor](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitImageProcessor) para procesar las imágenes).
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** `LevitForImageClassificationWithTeacherOutput` o `tuple(torch.Tensor)`
Un `LevitForImageClassificationWithTeacherOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([LevitConfig](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitConfig)) y las entradas.
El método forward de [LevitForImageClassificationWithTeacher](/docs/transformers/v5.23.0/es/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de predicción como el promedio de `cls_logits` y `distillation_logits`.
- **cls_logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de predicción de la cabeza de clasificación (es decir, la capa lineal sobre el estado oculto final del token de clase).
- **distillation_logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de predicción de la cabeza de destilación (es decir, la capa lineal sobre el estado oculto final del token de destilación).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
Ejemplo:
```python
>>> from transformers import AutoImageProcessor, LevitForImageClassificationWithTeacher
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/levit-128S")
>>> model = LevitForImageClassificationWithTeacher.from_pretrained("facebook/levit-128S")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```