# Deformable DETR
[Deformable DETR](https://huggingface.co/papers/2010.04159) улучшает оригинальную модель [DETR](./detr) за счёт использования модуля деформируемого внимания. Этот механизм селективно обращает внимание на небольшое множество ключевых точек выборки в окрестности опорной точки. Это повышает скорость обучения и точность.
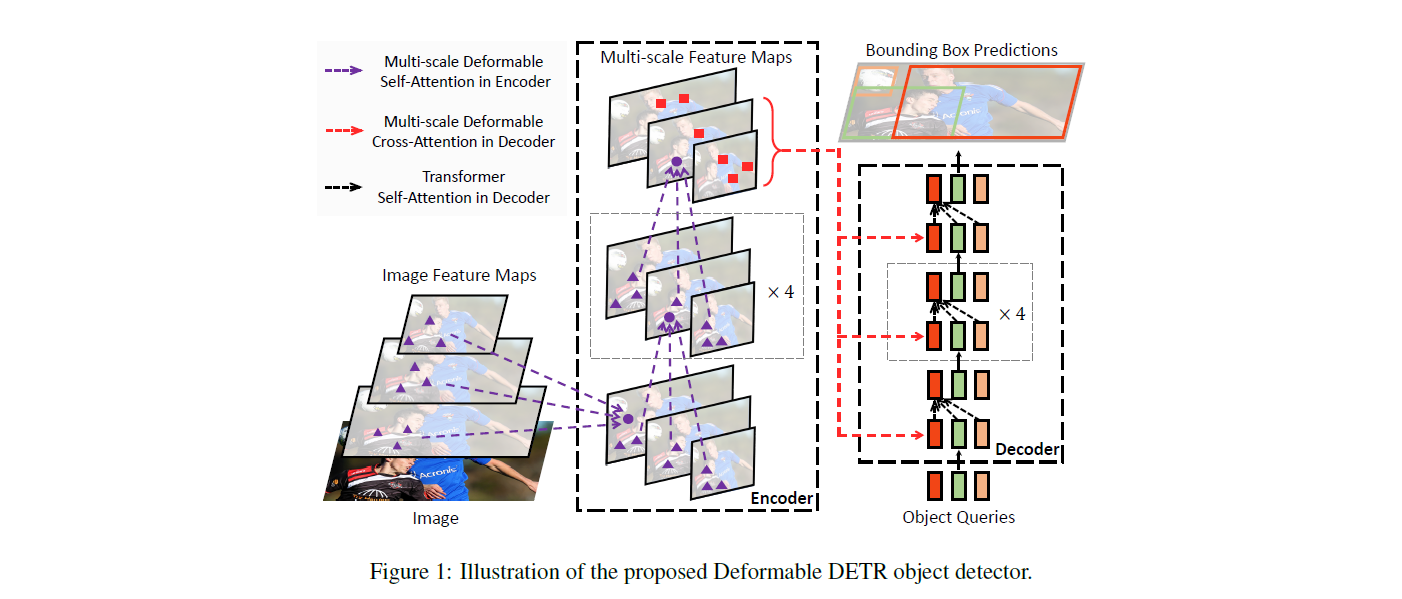 Архитектура Deformable DETR. Взято из оригинальной статьи.
Все доступные контрольные точки Deformable DETR можно найти в организации [SenseTime](https://huggingface.co/SenseTime).
> [!TIP]
> Эта модель была добавлена пользователем [nielsr](https://huggingface.co/nielsr).
>
> Щёлкните по моделям Deformable DETR в боковой панели справа, чтобы увидеть дополнительные примеры применения Deformable DETR к различным задачам обнаружения объектов и сегментации.
Приведённый ниже пример демонстрирует, как выполнять обнаружение объектов с помощью [Pipeline](/docs/transformers/main/ru/main_classes/pipelines#transformers.Pipeline) и класса [AutoModel](/docs/transformers/main/ru/model_doc/auto#transformers.AutoModel).
```python
from transformers import pipeline
pipeline = pipeline(
"object-detection",
model="SenseTime/deformable-detr",
device_map=0
)
pipeline("http://images.cocodataset.org/val2017/000000039769.jpg")
```
```python
import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, AutoModelForObjectDetection
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
model = AutoModelForObjectDetection.from_pretrained("SenseTime/deformable-detr", device_map="auto")
# prepare image for the model
inputs = image_processor(images=image, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = image_processor.post_process_object_detection(outputs, target_sizes=torch.tensor([image.size[::-1]]), threshold=0.3)
for result in results:
for score, label_id, box in zip(result["scores"], result["labels"], result["boxes"]):
score, label = score.item(), label_id.item()
box = [round(i, 2) for i in box.tolist()]
print(f"{model.config.id2label[label]}: {score:.2f} {box}")
```
## Ресурсы
- Обратитесь к этому набору [ноутбуков](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Deformable-DETR) для выполнения инференса и дообучения [DeformableDetrForObjectDetection](/docs/transformers/main/ru/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) на собственном наборе данных.
## DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
#### transformers.DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
```python
transformers.DeformableDetrImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L271)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 800, 'longest_edge': 1333}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
format (`str`, *kwargs*, *optional*, по умолчанию `AnnotationFormat.COCO_DETECTION`) : Формат данных аннотаций. Одно из значений "coco_detection" или "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Управляет преобразованием аннотаций в формат, ожидаемый моделью DEFORMABLE_DETR. Преобразует ограничивающие рамки в формат `(center_x, center_y, width, height)` в диапазоне `[0, 1]`. Может быть переопределено параметром `do_convert_annotations` в методе `preprocess`.
Создаёт процессор изображений DeformableDetrImageProcessor.
#### preprocess[[transformers.DeformableDetrImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L526)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
annotations (`AnnotationType` или `list[AnnotationType]`, *необязательный*) : Аннотации, которые необходимо преобразовать в соответствии с применяемым к изображениям выравниванием (padding).
return_segmentation_masks (`bool`, *необязательный*, по умолчанию `self.return_segmentation_masks`) : Нужно ли возвращать маски сегментации.
masks_path (`str` или `pathlib.Path`, *необязательный*) : Путь к каталогу, содержащему маски сегментации.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
format (`str`, *kwargs*, *optional*, по умолчанию `AnnotationFormat.COCO_DETECTION`) : Формат данных аннотаций. Одно из значений "coco_detection" или "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Управляет преобразованием аннотаций в формат, ожидаемый моделью DEFORMABLE_DETR. Преобразует ограничивающие рамки в формат `(center_x, center_y, width, height)` в диапазоне `[0, 1]`. Может быть переопределено параметром `do_convert_annotations` в методе `preprocess`.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessor.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L667)
**Параметры:**
outputs (`DetrObjectDetectionOutput`) : Сырые выходные данные модели.
threshold (`float`, *необязательный*) : Порог оценки для сохранения предсказаний обнаружения объектов.
target_sizes (`torch.Tensor` или `list[tuple[int, int]]`, *необязательный*) : тензор формы `(batch_size, 2)` или список кортежей (`tuple[int, int]`), содержащих целевой размер (высота, ширина) каждого изображения в батче. Если оставить значение None, предсказания не будут изменены в размере.
top_k (`int`, *optional*, по умолчанию 100) : Оставить только верхние k ограничивающих прямоугольников перед фильтрацией по порогу.
**Возвращает:** `list[Dict]`
Список словарей, где каждый словарь содержит оценки, метки и рамки для изображения в батче, как их предсказала модель.
Преобразует необработанный вывод [DeformableDetrForObjectDetection](/docs/transformers/main/ru/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) в итоговые ограничивающие прямоугольники в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y). Поддерживается только PyTorch.
## DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
#### transformers.DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
```python
transformers.DeformableDetrImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L263)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 800, 'longest_edge': 1333}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
format (`str`, *kwargs*, *optional*, по умолчанию `AnnotationFormat.COCO_DETECTION`) : Формат данных аннотаций. Одно из значений "coco_detection" или "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Управляет преобразованием аннотаций в формат, ожидаемый моделью DEFORMABLE_DETR. Преобразует ограничивающие рамки в формат `(center_x, center_y, width, height)` в диапазоне `[0, 1]`. Может быть переопределено параметром `do_convert_annotations` в методе `preprocess`.
Создаёт процессор изображений DeformableDetrImageProcessor.
#### preprocess[[transformers.DeformableDetrImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L531)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
annotations (`AnnotationType` или `list[AnnotationType]`, *необязательный*) : Аннотации, которые необходимо преобразовать в соответствии с применяемым к изображениям выравниванием (padding).
return_segmentation_masks (`bool`, *необязательный*, по умолчанию `self.return_segmentation_masks`) : Нужно ли возвращать маски сегментации.
masks_path (`str` или `pathlib.Path`, *необязательный*) : Путь к каталогу, содержащему маски сегментации.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
format (`str`, *kwargs*, *optional*, по умолчанию `AnnotationFormat.COCO_DETECTION`) : Формат данных аннотаций. Одно из значений "coco_detection" или "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Управляет преобразованием аннотаций в формат, ожидаемый моделью DEFORMABLE_DETR. Преобразует ограничивающие рамки в формат `(center_x, center_y, width, height)` в диапазоне `[0, 1]`. Может быть переопределено параметром `do_convert_annotations` в методе `preprocess`.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L676)
**Параметры:**
outputs (`DetrObjectDetectionOutput`) : Сырые выходные данные модели.
threshold (`float`, *необязательный*) : Порог оценки для сохранения предсказаний обнаружения объектов.
target_sizes (`torch.Tensor` или `list[tuple[int, int]]`, *необязательный*) : тензор формы `(batch_size, 2)` или список кортежей (`tuple[int, int]`), содержащих целевой размер (высота, ширина) каждого изображения в батче. Если оставить значение None, предсказания не будут изменены в размере.
top_k (`int`, *optional*, по умолчанию 100) : Оставить только верхние k ограничивающих прямоугольников перед фильтрацией по порогу.
**Возвращает:** `list[Dict]`
Список словарей, где каждый словарь содержит оценки, метки и рамки для изображения в батче, как их предсказала модель.
Преобразует необработанный вывод [DeformableDetrForObjectDetection](/docs/transformers/main/ru/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) в итоговые ограничивающие прямоугольники в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y). Поддерживается только PyTorch.
## DeformableDetrConfig[[transformers.DeformableDetrConfig]]
#### transformers.DeformableDetrConfig[[transformers.DeformableDetrConfig]]
```python
transformers.DeformableDetrConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_channels: int = 3, num_queries: int = 300, max_position_embeddings: int = 1024, encoder_layers: int = 6, encoder_ffn_dim: int = 1024, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 1024, decoder_attention_heads: int = 8, encoder_layerdrop: float | int = 0.0, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, init_std: float = 0.02, init_xavier_std: float = 1.0, return_intermediate: bool = True, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', dilation: bool = False, num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = False, two_stage_num_proposals: int = 300, with_box_refine: bool = False, class_cost: int = 1, bbox_cost: int = 5, giou_cost: int = 2, mask_loss_coefficient: int = 1, dice_loss_coefficient: int = 1, bbox_loss_coefficient: int = 5, giou_loss_coefficient: int = 2, eos_coefficient: float = 0.1, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, tie_word_embeddings: bool = True)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/configuration_deformable_detr.py#L25)
**Параметры:**
is_encoder_decoder (`bool`, *необязательный*, по умолчанию `True`) : Используется ли модель в качестве энкодера/декодера.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Конфигурация базовой модели.
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
num_queries (`int`, *optional*, по умолчанию 300) : Количество запросов объектов, то есть слотов для обнаружения. Это максимальное число объектов, которые [DeformableDetrModel](/docs/transformers/main/ru/model_doc/deformable_detr#transformers.DeformableDetrModel) может обнаружить на одном изображении. Если `two_stage` установлено в `True`, используется `two_stage_num_proposals`.
max_position_embeddings (`int`, *необязательный*, по умолчанию `1024`) : Максимальная длина последовательности, с которой может использоваться данная модель.
encoder_layers (`int`, *необязательный*, по умолчанию `6`) : Количество скрытых слоев в кодере Transformer. Если не задано, будет использовано то же значение, что и у `num_layers`.
encoder_ffn_dim (`int`, *optional*, по умолчанию `1024`) : Размерность «промежуточного» (часто называемого feed-forward) слоя в энкодере.
encoder_attention_heads (`int`, *необязательный*, по умолчанию `8`) : Количество головок внимания для каждого слоя внимания в кодере Transformer.
decoder_layers (`int`, *необязательный*, по умолчанию `6`) : Количество скрытых слоев в декодере Transformer. Если не задано, будет использовано то же значение, что и у `num_layers`.
decoder_ffn_dim (`int`, *optional*, по умолчанию `1024`) : Размерность «промежуточного» (часто называемого feed-forward) слоя в декодере.
decoder_attention_heads (`int`, *необязательный*, по умолчанию `8`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
encoder_layerdrop (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Вероятность LayerDrop для энкодера. Подробнее см. в [статье о LayerDrop](see https://huggingface.co/papers/1909.11556).
activation_function (`str`, *необязательный*, по умолчанию `relu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
d_model (`int`, *необязательный*, по умолчанию `256`) : Размер слоев кодировщика и пулера.
dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Доля для всех слоёв dropout.
attention_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
activation_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для активаций внутри полносвязного слоя.
init_std (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
init_xavier_std (`float`, *необязательный*, по умолчанию `1.0`) : Коэффициент масштабирования, используемый для инициализации кросс-внимания по методу Ксавье.
return_intermediate (`bool`, *необязательный*, по умолчанию True) : Возвращать промежуточное состояние или нет
auxiliary_loss (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли вспомогательные потери декодирования (потери на каждом слое декодера).
position_embedding_type (`str`, *необязательный*, по умолчанию `"sine"`) : Тип позиционных эмбеддингов, применяемых поверх признаков изображения. Одно из значений `"sine"` или `"learned"`.
dilation (`bool`, *необязательный*, по умолчанию `False`) : Заменять ли stride на dilation в последнем свёрточном блоке (DC5). Поддерживается только при `use_timm_backbone` = `True`.
num_feature_levels (`int`, *необязательный*, по умолчанию 4) : Количество уровней входных признаков.
encoder_n_points (`int`, *optional*, по умолчанию 4) : Количество выбранных ключей на каждом уровне признаков для каждой головы внимания в кодере.
decoder_n_points (`int`, *optional*, по умолчанию 4) : Количество выбранных ключей на каждом уровне признаков для каждой головы внимания в декодере.
two_stage (`bool`, *необязательный*, по умолчанию `False`) : Указывает, следует ли применять двухэтапный деформируемый DETR, в котором предложения областей также генерируются вариантом Deformable DETR и далее передаются в декодер для итеративного уточнения ограничивающих прямоугольников.
two_stage_num_proposals (`int`, *optional*, по умолчанию 300) : Количество генерируемых региональных предложений, если `two_stage` установлено в `True`.
with_box_refine (`bool`, *необязательный*, по умолчанию `False`) : Указывает, следует ли применять итеративное уточнение ограничивающих прямоугольников, при котором каждый слой декодера уточняет прямоугольники на основе предсказаний предыдущего слоя.
class_cost (`int`, *optional*, по умолчанию `1`) : Относительный вес ошибки классификации в стоимости венгерского сопоставления.
bbox_cost (`int`, *optional*, по умолчанию `5`) : Относительный вес ошибки L1 для ограничивающих прямоугольников в стоимости венгерского сопоставления.
giou_cost (`int`, *optional*, по умолчанию `2`) : Относительный вес обобщённой функции потерь IoU в стоимости венгерского сопоставления.
mask_loss_coefficient (`int`, *optional*, по умолчанию `1`) : Относительный вес фокальной функции потерь в функции потерь паноптической сегментации.
dice_loss_coefficient (`int`, *optional*, по умолчанию `1`) : Относительный вес функции потерь dice в функции потерь паноптической сегментации.
bbox_loss_coefficient (`int`, *optional*, по умолчанию `5`) : Относительный вес потери L1 для ограничивающих прямоугольников в потере паноптической сегментации.
giou_loss_coefficient (`int`, *optional*, по умолчанию `2`) : Относительный вес обобщённой функции потерь IoU в функции потерь паноптической сегментации.
eos_coefficient (`float`, *необязательный*, по умолчанию `0.1`) : Относительный вес класса «нет объекта» в функции потерь обнаружения объектов.
focal_alpha (`float`, *необязательный*, по умолчанию `0.25`) : Параметр alpha в функции потерь focal loss.
disable_custom_kernels (`bool`, *необязательный*, по умолчанию `False`) : Отключает использование собственных CUDA- и CPU-ядер. Эта опция необходима для экспорта в ONNX, так как собственные ядра не поддерживаются экспортом PyTorch в ONNX.
tie_word_embeddings (`bool`, *необязательный*, по умолчанию `True`) : Связывать ли веса эмбеддингов согласно отображению `tied_weights_keys` модели.
Это класс конфигурации для хранения настроек модели DeformableDetrModel. Он используется для создания модели Deformable Detr в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [SenseTime/deformable-detr](https://huggingface.co/SenseTime/deformable-detr)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
Примеры:
```python
>>> from transformers import DeformableDetrConfig, DeformableDetrModel
>>> # Initializing a Deformable DETR SenseTime/deformable-detr style configuration
>>> configuration = DeformableDetrConfig()
>>> # Initializing a model (with random weights) from the SenseTime/deformable-detr style configuration
>>> model = DeformableDetrModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## DeformableDetrModel[[transformers.DeformableDetrModel]]
#### transformers.DeformableDetrModel[[transformers.DeformableDetrModel]]
```python
transformers.DeformableDetrModel(config: DeformableDetrConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1145)
**Параметры:**
config ([DeformableDetrConfig](/docs/transformers/main/ru/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Deformable DETR без дополнительных компонентов (состоящая из backbone и encoder-decoder Transformer), выводящая «сырые» hidden-states без какого-либо специализированного head сверху.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.DeformableDetrModel.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1319)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью `image_processor_class`. Подробности см. в `image_processor_class.__call__` (`processor_class` использует `image_processor_class` для обработки изображений).
pixel_mask (`torch.LongTensor` формы `(batch_size, height, width)`, *необязательно*) : Маска для исключения значений пикселей отступов из внимания. Значения маски выбираются из `[0, 1]`: - 1 для реальных пикселей (т. е. **не замаскированных**), - 0 для пикселей отступов (т. е. **замаскированных**). [Что такое маски внимания?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` формы `(batch_size, num_queries)`, *необязательный*) : По умолчанию не используется. Может применяться для маскирования запросов объектов.
encoder_outputs (`torch.Tensor`, *необязательный*) : Кортеж, состоящий из (`last_hidden_state`, *необязательный*: `hidden_states`, *необязательный*: `attentions`) `last_hidden_state` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) представляет собой последовательность скрытых состояний на выходе последнего слоя кодировщика. Используется в кросс-внимании декодера.
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи сглаженной карты признаков (выход backbone + проекционного слоя), можно напрямую передать сглаженное представление изображения.
decoder_inputs_embeds (`torch.Tensor` формы `(batch_size, num_queries, hidden_size)`, *необязательно*) : По желанию, вместо инициализации запросов тензором нулей, можно передать встроенное представление напрямую.
**Возвращает:** `DeformableDetrModelOutput` или `tuple(torch.Tensor)`
`DeformableDetrModelOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации (`None`) и входных данных.
Метод forward модели [DeformableDetrModel](/docs/transformers/main/ru/model_doc/deformable_detr#transformers.DeformableDetrModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **init_reference_points** (`torch.Tensor` формы `(batch_size, num_queries, 4)`) -- Начальные опорные точки, передаваемые через декодер Transformer.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, num_queries, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя декодера модели.
- **intermediate_hidden_states** (`torch.Tensor` формы `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Стек промежуточных скрытых состояний (выход каждого слоя декодера).
- **intermediate_reference_points** (`torch.Tensor` формы `(batch_size, config.decoder_layers, num_queries, 4)`) -- Стек промежуточных опорных точек (опорные точки каждого слоя декодера).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода эмбеддингов, если у модели есть слой эмбеддингов, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния декодера на выходе каждого слоя, а также выходные значения начального слоя встраивания.
- **decoder_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
- **encoder_last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя энкодера модели.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния кодировщика на выходе каждого слоя, а также выходные значения начального слоя встраиваний.
- **encoder_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) — Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания энкодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **enc_outputs_class** (`torch.Tensor` формы `(batch_size, sequence_length, config.num_labels)`, *необязательный*, возвращается, если `config.with_box_refine=True` и `config.two_stage=True`) -- Оценки предсказанных ограничивающих прямоугольников, где в первом этапе в качестве региональных предложений выбираются `config.two_stage_num_proposals` прямоугольников с наивысшими оценками. Результат бинарной классификации ограничивающих прямоугольников (т. е. передний план и фон).
- **enc_outputs_coord_logits** (`torch.Tensor` формы `(batch_size, sequence_length, 4)`, *необязательный*, возвращается, если `config.with_box_refine=True` и `config.two_stage=True`) -- Логиты координат предсказанных ограничивающих прямоугольников на первом этапе.
Примеры:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrModel.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 300, 256]
```
## DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
#### transformers.DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
```python
transformers.DeformableDetrForObjectDetection(config: DeformableDetrConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1542)
**Параметры:**
config ([DeformableDetrConfig](/docs/transformers/main/ru/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Deformable DETR (состоящая из backbone и encoder-decoder Transformer) с головками для обнаружения объектов, предназначенная для таких задач, как COCO detection.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.DeformableDetrForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, labels: list[dict] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1580)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью `image_processor_class`. Подробности см. в `image_processor_class.__call__` (`processor_class` использует `image_processor_class` для обработки изображений).
pixel_mask (`torch.LongTensor` формы `(batch_size, height, width)`, *необязательно*) : Маска для исключения значений пикселей отступов из внимания. Значения маски выбираются из `[0, 1]`: - 1 для реальных пикселей (т. е. **не замаскированных**), - 0 для пикселей отступов (т. е. **замаскированных**). [Что такое маски внимания?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` формы `(batch_size, num_queries)`, *необязательный*) : По умолчанию не используется. Может применяться для маскирования запросов объектов.
encoder_outputs (`torch.Tensor`, *необязательный*) : Кортеж, состоящий из (`last_hidden_state`, *необязательный*: `hidden_states`, *необязательный*: `attentions`) `last_hidden_state` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) представляет собой последовательность скрытых состояний на выходе последнего слоя кодировщика. Используется в кросс-внимании декодера.
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи сглаженной карты признаков (выход backbone + проекционного слоя), можно напрямую передать сглаженное представление изображения.
decoder_inputs_embeds (`torch.Tensor` формы `(batch_size, num_queries, hidden_size)`, *необязательно*) : По желанию, вместо инициализации запросов тензором нулей, можно передать встроенное представление напрямую.
labels (`list[Dict]` длины `(batch_size,)`, *необязательный*) : Метки для вычисления функции потерь бипартитного сопоставления. Список словарей, каждый из которых содержит как минимум следующие два ключа: 'class_labels' и 'boxes' (соответственно, метки классов и ограничивающие рамки изображения в батче). Сами метки классов должны представлять собой `torch.LongTensor` длины `(number of bounding boxes in the image,)`, а рамки — `torch.Tensor` формы `(number of bounding boxes in the image, 4)`.
**Возвращает:** `DeformableDetrObjectDetectionOutput` или `tuple(torch.Tensor)`
`DeformableDetrObjectDetectionOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации (`None`) и входных данных.
Метод forward класса [DeformableDetrForObjectDetection](/docs/transformers/main/ru/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если предоставлены `labels`)) -- Суммарная потеря, представляющая собой линейную комбинацию отрицательного логарифма правдоподобия (кросс-энтропии) для предсказания класса и потери для ограничивающих прямоугольников. Последняя определяется как линейная комбинация L1-потери и обобщенной масштабно-инвариантной потери IoU.
- **loss_dict** (`Dict`, *необязательный*) -- Словарь, содержащий отдельные значения потерь. Полезно для ведения журнала.
- **logits** (`torch.Tensor` формы `(batch_size, num_queries, num_classes + 1)`) -- Логиты классификации (включая no-object) для всех запросов.
- **pred_boxes** (`torch.Tensor` формы `(batch_size, num_queries, 4)`) -- Нормализованные координаты границ для всех запросов, представленные в виде (center_x, center_y, width, height). Эти значения нормализованы в диапазоне [0, 1] относительно размера каждого отдельного изображения в батче (игнорируя возможное выравнивание). Для получения ненормализованных границ используйте `~DeformableDetrProcessor.post_process_object_detection`.
- **auxiliary_outputs** (`list[Dict]`, *необязательный*) -- Необязательный параметр, возвращается только при активации вспомогательных потерь (т. е. когда `config.auxiliary_loss` установлен в `True`) и при наличии меток. Это список словарей, содержащих два указанных выше ключа (`logits` и `pred_boxes`) для каждого слоя декодера.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, num_queries, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя декодера модели.
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода эмбеддингов, если у модели есть слой эмбеддингов, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния декодера на выходе каждого слоя, а также выходные значения начального слоя встраивания.
- **decoder_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
- **encoder_last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя энкодера модели.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния кодировщика на выходе каждого слоя, а также выходные значения начального слоя встраиваний.
- **encoder_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) — Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания энкодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **init_reference_points** (`torch.Tensor` формы `(batch_size, num_queries, 4)`) -- Начальные опорные точки, передаваемые через декодер Transformer.
- **intermediate_hidden_states** (`torch.Tensor` формы `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Стек промежуточных скрытых состояний (выход каждого слоя декодера).
- **intermediate_reference_points** (`torch.Tensor` формы `(batch_size, config.decoder_layers, num_queries, 4)`) -- Стек промежуточных опорных точек (опорные точки каждого слоя декодера).
- **enc_outputs_class** (`torch.Tensor` формы `(batch_size, sequence_length, config.num_labels)`, *необязательный*, возвращается, если `config.with_box_refine=True` и `config.two_stage=True`) -- Оценки предсказанных ограничивающих прямоугольников, где в первом этапе в качестве региональных предложений выбираются `config.two_stage_num_proposals` прямоугольников с наивысшими оценками. Результат бинарной классификации ограничивающих прямоугольников (т. е. передний план и фон).
- **enc_outputs_coord_logits** (`torch.Tensor` формы `(batch_size, sequence_length, 4)`, *необязательный*, возвращается, если `config.with_box_refine=True` и `config.two_stage=True`) -- Логиты координат предсказанных ограничивающих прямоугольников на первом этапе.
Примеры:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrForObjectDetection
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrForObjectDetection.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.5, target_sizes=target_sizes)[
... 0
... ]
>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
... box = [round(i, 2) for i in box.tolist()]
... print(
... f"Detected {model.config.id2label[label.item()]} with confidence "
... f"{round(score.item(), 3)} at location {box}"
... )
Detected cat with confidence 0.8 at location [16.5, 52.84, 318.25, 470.78]
Detected cat with confidence 0.789 at location [342.19, 24.3, 640.02, 372.25]
Detected remote with confidence 0.633 at location [40.79, 72.78, 176.76, 117.25]
```