# SAM
## Genel Bakış
SAM (Segment Anything Model), Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar ve Ross Girshick tarafından [Segment Anything](https://huggingface.co/papers/2304.02643) makalesinde önerilmiştir.
Model, girdi olarak bir görüntü verildiğinde ilgi çekici herhangi bir nesnenin segmentasyon maskelerini tahmin etmek için kullanılabilir.
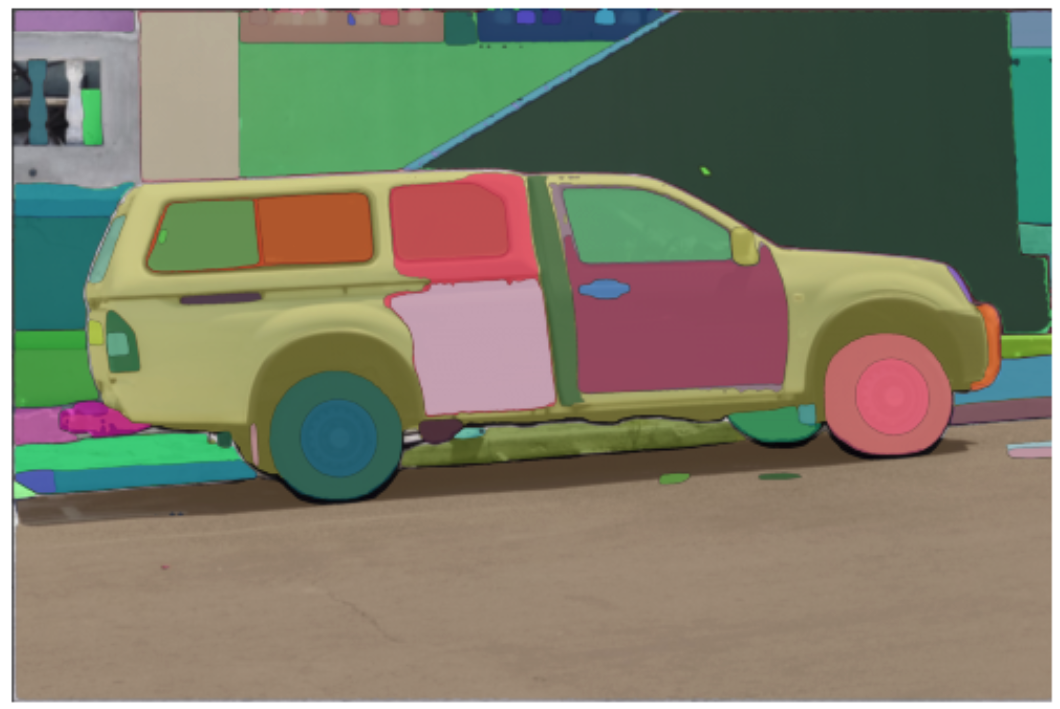
Makalenin özeti aşağıdaki gibidir:
*Segment Anything (SA) projesini tanıtıyoruz: görüntü segmentasyonu için yeni bir görev, model ve veri seti. Veri toplama döngüsünde verimli modelimizi kullanarak, 11M lisanslı ve gizliliğe saygılı görüntü üzerinde 1 milyardan fazla maske içeren, bugüne kadarki en büyük segmentasyon veri setini (çok açık ara) oluşturduk. Model, sıfır atışla (zero-shot) yeni görüntü dağılımlarına ve görevlere aktarılabilmesi için istemlenebilir (promptable) olacak şekilde tasarlanmış ve eğitilmiştir. Yeteneklerini çeşitli görevlerde değerlendiriyoruz ve sıfır atış performansının etkileyici olduğunu, çoğu zaman önceki tam denetimli (fully supervised) sonuçlarla rekabet edebilir veya hatta onlardan üstün olduğunu görüyoruz. Bilgisayarla görü alanındaki temel modeller (foundation models) üzerine araştırmaları teşvik etmek için Segment Anything Model (SAM) ve 1B maske ile 11M görüntüden oluşan ilgili veri setini (SA-1B) [https://segment-anything.com](https://segment-anything.com) adresinde yayınlıyoruz.*
İpuçları:
- Model, verilen bir görüntüde ilgili nesnenin var olup olmadığını belirten ikili maskeler tahmin eder.
- Girdi olarak 2B noktalar ve/veya girdi olarak sınırlayıcı kutular sağlandığında model çok daha iyi sonuçlar tahmin eder
- Aynı görüntü için birden çok nokta girebilir ve tek bir maske tahmin edebilirsiniz.
- Modelin ince ayarı henüz desteklenmiyor
- Makaleye göre metinsel giriş de desteklenmelidir. Ancak bu yazının kaleme alındığı dönemde, [resmi depoya](https://github.com/facebookresearch/segment-anything/issues/4#issuecomment-1497626844) göre bunun desteklenmediği görülmektedir.
Bu model [ybelkada](https://huggingface.co/ybelkada) ve [ArthurZ](https://huggingface.co/ArthurZ) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/facebookresearch/segment-anything) bulunabilir.
Aşağıda, bir görüntü ve 2B bir nokta verildiğinde maske üretiminin nasıl çalıştırılacağına dair bir örnek bulunmaktadır:
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
İşlenmiş maskeleri, modele aktarılacak şekilde, girdi görüntüleriyle birlikte işlemcide de işleyebilirsiniz.
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
## Kaynaklar
SAM ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi.
- Modeli kullanmak için [demo defter](https://github.com/huggingface/notebooks/blob/main/examples/segment_anything.ipynb).
- Otomatik maske oluşturma hattını kullanmak için [demo defter](https://github.com/huggingface/notebooks/blob/main/examples/automatic_mask_generation.ipynb).
- MedSAM ile çıkarım için [demo defter](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Run_inference_with_MedSAM_using_HuggingFace_Transformers.ipynb), tıbbi alanda ince ayarlanmış bir SAM sürümü. 🌎
- Özel verilerde modelin ince ayarını yapmak için [demo defter](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Fine_tune_SAM_(segment_anything)_on_a_custom_dataset.ipynb). 🌎
## SlimSAM
Zigeng Chen ve diğerleri tarafından [0.1% Data Makes Segment Anything Slim](https://huggingface.co/papers/2312.05284) makalesinde önerilen SlimSAM, SAM'ın budanmış bir versiyonudur. SlimSAM, aynı performansı korurken SAM modellerinin boyutunu önemli ölçüde azaltır.
Kontrol noktaları [hub](https://huggingface.co/models?other=slimsam) üzerinde bulunabilir ve SAM'in doğrudan yerini alacak şekilde kullanılabilir.
## Grounded SAM
[Grounding DINO](grounding-dino), [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159) makalesinde tanıtıldığı gibi, metin tabanlı maske üretimi için SAM ile birleştirilebilir. Detaylar için bu [demo defterine](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍 bakabilirsiniz.
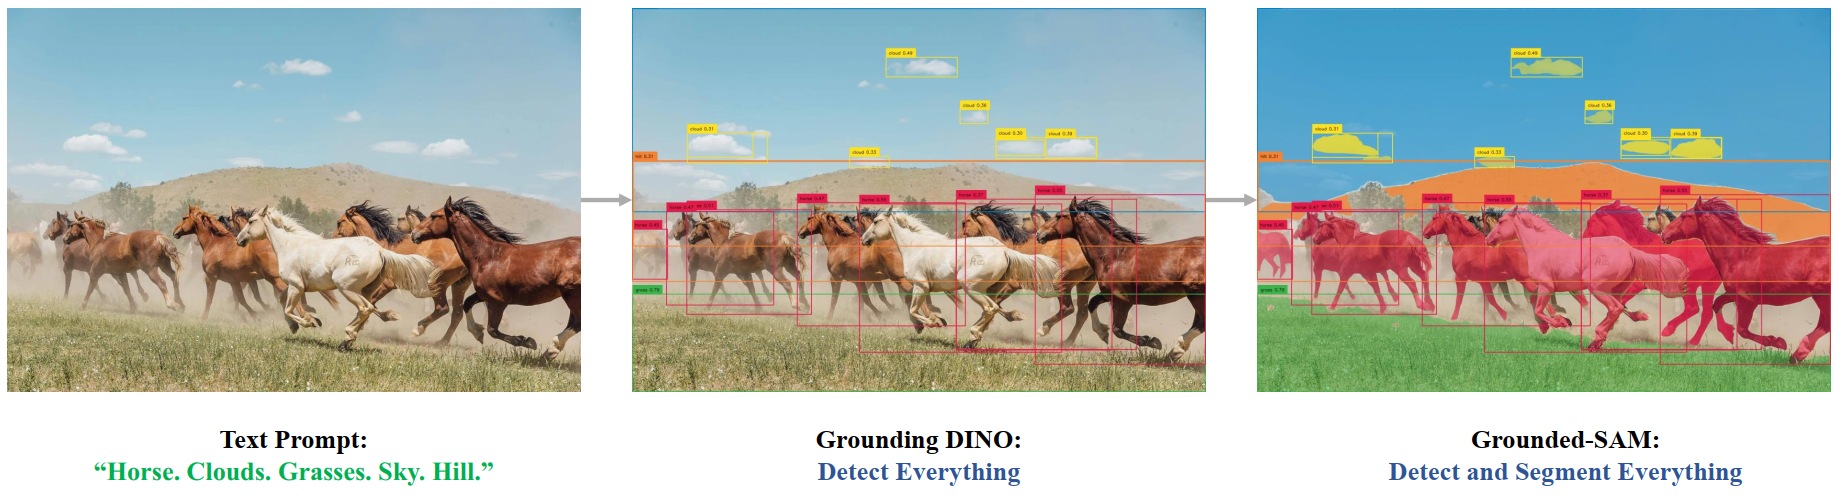 Grounded SAM genel bakış. Orijinal depodan alınmıştır.
## SamConfig[[transformers.SamConfig]]
#### transformers.SamConfig[[transformers.SamConfig]]
```python
transformers.SamConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, prompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, mask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, initializer_range: float = 0.02, tie_word_embeddings: bool = True)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L146)
**Parametreler:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Görüntü iskeletinin yapılandırma nesnesi veya sözlüğü.
prompt_encoder_config (Union[`dict`, `SamPromptEncoderConfig`], *opsiyonel*) : [SamPromptEncoderConfig](/docs/transformers/main/tr/model_doc/sam#transformers.SamPromptEncoderConfig) sınıfını başlatmak için kullanılan yapılandırma seçeneklerinin sözlüğü.
mask_decoder_config (Union[`dict`, `SamMaskDecoderConfig`], *opsiyonel*) : [SamMaskDecoderConfig](/docs/transformers/main/tr/model_doc/sam#transformers.SamMaskDecoderConfig) sınıfını başlatmak için kullanılan yapılandırma seçeneklerinin sözlüğü.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
tie_word_embeddings (`bool`, *isteğe bağlı*, varsayılan `True`) : Ağırlık gömme bağlamalarının, modelin `tied_weights_keys` eşlemesine göre yapılıp yapılmayacağını belirtir.
Bu, bir SamModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Sam modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import (
... SamVisionConfig,
... SamPromptEncoderConfig,
... SamMaskDecoderConfig,
... SamModel,
... )
>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()
>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig
>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()
>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
```
## SamVisionConfig[[transformers.SamVisionConfig]]
#### transformers.SamVisionConfig[[transformers.SamVisionConfig]]
```python
transformers.SamVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, output_channels: int = 256, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True, mlp_ratio: float = 4.0, use_abs_pos: bool = True, use_rel_pos: bool = True, window_size: int = 14, global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11), num_pos_feats: int = 128, mlp_dim: int | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L81)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
output_channels (`int`, *isteğe bağlı*, varsayılan 256) : Patch Encoder'daki çıktı kanallarının boyutluluğu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `1024`) : Her bir görüntünün boyutu (çözünürlüğü).
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `16`) : Her yamanın boyutu (çözünürlüğü).
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-06`) : Katman normalizasyonu katmanlarında kullanılan epsilon.
attention_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
initializer_range (`float`, *isteğe bağlı*, varsayılan `1e-10`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
qkv_bias (`bool`, *isteğe bağlı*, varsayılan `True`) : Sorgulara, anahtarlara ve değerlere bir sapma (bias) eklenip eklenmeyeceğini belirtir.
mlp_ratio (`float`, *isteğe bağlı*, varsayılan `4.0`) : MLP gizli boyutunun gömme boyutuna oranı.
use_abs_pos (`bool`, *isteğe bağlı*, varsayılan `True`) : Mutlak konum gömme kullanılıp kullanılmayacağı.
use_rel_pos (`bool`, *isteğe bağlı*, varsayılan `True`) : Göreceli konum gömme kullanılıp kullanılmayacağı.
window_size (`int`, *isteğe bağlı*, varsayılan 14) : Göreli konum için pencere boyutu.
global_attn_indexes (`list[int]`, *isteğe bağlı*, varsayılan `[2, 5, 8, 11]`) : Küresel dikkat katmanlarının indeksleri.
num_pos_feats (`int`, *isteğe bağlı*, varsayılan 128) : Konum gömme (position embedding) boyutluluğu.
mlp_dim (`int`, *opsiyonel*) : Transformer kodlayıcısındaki MLP katmanının boyutluluğu. `None` ise, varsayılan olarak `mlp_ratio * hidden_size` değerini alır.
Bu, bir SamModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Sam modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import (
... SamVisionConfig,
... SamVisionModel,
... )
>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()
>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
#### transformers.SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
```python
transformers.SamMaskDecoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, hidden_act: str = 'relu', mlp_dim: int = 2048, num_hidden_layers: int = 2, num_attention_heads: int = 8, attention_downsample_rate: int = 2, num_multimask_outputs: int = 3, iou_head_depth: int = 3, iou_head_hidden_dim: int = 256, layer_norm_eps: float = 1e-06)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L50)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `256`) : Gizli temsillerin boyutu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `relu`) : Dekoderdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
mlp_dim (`int`, *opsiyonel*, varsayılan 2048) : Transformer kodlayıcısındaki "ara" (yani, ileri beslemeli) katmanın boyutluluğu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `2`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `8`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
attention_downsample_rate (`int`, *isteğe bağlı*, varsayılan 2) : Dikkat katmanının indirgeme oranı.
num_multimask_outputs (`int`, *isteğe bağlı*, varsayılan 3) : `SamMaskDecoder` modülünden gelen çıktı sayısı. Segment Anything makalesinde bu değer 3 olarak ayarlanmıştır.
iou_head_depth (`int`, *isteğe bağlı*, varsayılan 3) : IoU başlığı modülündeki katman sayısı.
iou_head_hidden_dim (`int`, *opsiyonel*, varsayılan 256) : IoU başlığı modülündeki gizli durumların boyutluluğu.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-06`) : Katman normalizasyonu katmanlarında kullanılan epsilon.
Bu, bir SamModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Sam modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
## SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
#### transformers.SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
```python
transformers.SamPromptEncoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, mask_input_channels: int = 16, num_point_embeddings: int = 4, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L24)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `256`) : Gizli temsillerin boyutu.
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `1024`) : Her bir görüntünün boyutu (çözünürlüğü).
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `16`) : Her yamanın boyutu (çözünürlüğü).
mask_input_channels (`int`, *isteğe bağlı*, varsayılan 16) : `MaskDecoder` modülüne verilecek kanal sayısı.
num_point_embeddings (`int`, *isteğe bağlı*, varsayılan 4) : Kullanılacak nokta gömme sayısı.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-06`) : Katman normalizasyonu katmanlarında kullanılan epsilon.
Bu, bir SamModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Sam modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
## SamProcessor[[transformers.SamProcessor]]
#### transformers.SamProcessor[[transformers.SamProcessor]]
```python
transformers.SamProcessor(image_processor)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/processing_sam.py#L82)
**Parametreler:**
image_processor (`SamImageProcessor`) : Görüntü işleyici zorunlu bir girdidir.
Bir görüntü işleyicisini tek bir işleyiciye sararak bir SamProcessor oluşturur.
[SamProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamProcessor), [SamImageProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamImageProcessor)'ün tüm işlevlerini sunar. Daha fazla bilgi için [~SamImageProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamImageProcessor) sayfasına bakın.
#### __call__[[transformers.SamProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/processing_sam.py#L87)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
text (`Union[str, list[str], list[list[str]]]`, *isteğe bağlı*) : Kodlanacak dizi veya dizi topluluğu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Önceden tokenize edilmiş bir girdi geçirirseniz, toplu girdilerle karışıklığı önlemek için `is_split_into_words=True` değerini ayarlayın.
return_tensors (`str` veya [TensorType](/docs/transformers/main/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
**Dönüş:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *isteğe bağlı*) -- `__call__`/`encode_plus`/`batch_encode_plus` yöntemleri tarafından döndürülen listeler/diziler/tensörler sözlüğü ('input_ids', 'attention_mask' vb.).
- **encoding** (`tokenizers.Encoding` veya `Sequence[tokenizers.Encoding]`, *isteğe bağlı*) -- Tokenizer, kelime/karakter uzayından token uzayına eşleme gibi ek bilgiler üreten hızlı bir tokenizer ise, `tokenizers.Encoding` örneği veya örnekler listesi (toplu işlemler için) bu bilgileri barındırır.
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
- **prepend_batch_axis** (`bool`, *isteğe bağlı*, varsayılan `False`) -- Tensörlere dönüştürülürken bir batch ekseni eklenip eklenmeyeceğini belirtir (bkz. yukarıdaki `tensor_type`). `tensor_type` parametresi ayarlanmışsa bu parametrenin bir etkisi vardır, *aksi halde hiçbir etkisi yoktur*.
- **n_sequences** (`int`, *isteğe bağlı*) -- Her kodlamanın temsil ettiği girdi dizilerinin sayısı (`None` bilinmeyen, `1` tek bir dizi ve `2` dizi çifti için).
## SamImageProcessor[[transformers.SamImageProcessor]]
#### transformers.SamImageProcessor[[transformers.SamImageProcessor]]
```python
transformers.SamImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_sam.py#L61)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'longest_edge' : 1024}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 1024, 'width': 1024}`): Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
mask_size (`dict[str, *kwargs*, int]`, *isteğe bağlı*) : Segmentasyon haritalarının yeniden boyutlandırılacağı `{"longest_edge": int}` boyutu.
mask_pad_size (`dict[str, *kwargs*, int]`, *isteğe bağlı*) : Segmentasyon haritalarının boyutlandırılacağı `{"height": int, "width": int}` boyutu. Ön işleme için sağlanan herhangi bir segmentasyon haritası boyutundan büyük olmalıdır.
SamImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.SamImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_sam.py#L79)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
segmentation_maps (`ImageInput`, *isteğe bağlı*) : Ön işleme tabi tutulacak segmentasyon haritaları.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
mask_size (`dict[str, *kwargs*, int]`, *isteğe bağlı*) : Segmentasyon haritalarının yeniden boyutlandırılacağı `{"longest_edge": int}` boyutu.
mask_pad_size (`dict[str, *kwargs*, int]`, *isteğe bağlı*) : Segmentasyon haritalarının boyutlandırılacağı `{"height": int, "width": int}` boyutu. Ön işleme için sağlanan herhangi bir segmentasyon haritası boyutundan büyük olmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## SamImageProcessorPil[[transformers.SamImageProcessorPil]]
#### transformers.SamImageProcessorPil[[transformers.SamImageProcessorPil]]
```python
transformers.SamImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_pil_sam.py#L82)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'longest_edge' : 1024}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 1024, 'width': 1024}`): Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
mask_size (`dict[str, *kwargs*, int]`, *isteğe bağlı*) : Segmentasyon haritalarının yeniden boyutlandırılacağı `{"longest_edge": int}` boyutu.
mask_pad_size (`dict[str, *kwargs*, int]`, *isteğe bağlı*) : Segmentasyon haritalarının boyutlandırılacağı `{"height": int, "width": int}` boyutu. Ön işleme için sağlanan herhangi bir segmentasyon haritası boyutundan büyük olmalıdır.
SamImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.SamImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_pil_sam.py#L100)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
segmentation_maps (`ImageInput`, *isteğe bağlı*) : Ön işleme tabi tutulacak segmentasyon haritaları.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
mask_size (`dict[str, *kwargs*, int]`, *isteğe bağlı*) : Segmentasyon haritalarının yeniden boyutlandırılacağı `{"longest_edge": int}` boyutu.
mask_pad_size (`dict[str, *kwargs*, int]`, *isteğe bağlı*) : Segmentasyon haritalarının boyutlandırılacağı `{"height": int, "width": int}` boyutu. Ön işleme için sağlanan herhangi bir segmentasyon haritası boyutundan büyük olmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## SamVisionModel[[transformers.SamVisionModel]]
#### transformers.SamVisionModel[[transformers.SamVisionModel]]
```python
transformers.SamVisionModel(config: SamVisionConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1081)
**Parametreler:**
config ([SamVisionConfig](/docs/transformers/main/tr/model_doc/sam#transformers.SamVisionConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde herhangi bir başlık veya projeksiyon olmadan Sam'dan gelen görme modeli.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.SamVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1093)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [SamImageProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [SamImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([SamProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamProcessor), görüntü işleme için [SamImageProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamImageProcessor) kullanır).
**Dönüş:** `SamVisionEncoderOutput` veya `tuple(torch.Tensor)`
`SamVisionEncoderOutput` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([SamConfig](/docs/transformers/main/tr/model_doc/sam#transformers.SamConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[SamVisionModel](/docs/transformers/main/tr/model_doc/sam#transformers.SamVisionModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **image_embeds** (`torch.Tensor`, şekli `(batch_size, output_dim)`, *isteğe bağlı*, model `with_projection=True` ile başlatıldığında döndürülür) -- pooler_output'a projeksiyon katmanının uygulanmasıyla elde edilen gömme değerleri.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple[torch.Tensor, ...]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
## SamModel[[transformers.SamModel]]
#### transformers.SamModel[[transformers.SamModel]]
```python
transformers.SamModel(config: SamConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1108)
**Parametreler:**
config ([SamConfig](/docs/transformers/main/tr/model_doc/sam#transformers.SamConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Girdi olarak bir görüntü ile girdi noktaları ve etiketleri, kutuları veya maskeleri verildiğinde segmentasyon maskeleri üretmek için Segment Anything Model (SAM).
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.SamModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, input_points: typing.Optional[torch.Tensor] = None, input_labels: typing.Optional[torch.LongTensor] = None, input_boxes: typing.Optional[torch.Tensor] = None, input_masks: typing.Optional[torch.LongTensor] = None, image_embeddings: typing.Optional[torch.Tensor] = None, multimask_output: bool = True, attention_similarity: typing.Optional[torch.Tensor] = None, target_embedding: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1191)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [SamImageProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [SamImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([SamProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamProcessor), görüntü işleme için [SamImageProcessor](/docs/transformers/main/tr/model_doc/sam#transformers.SamImageProcessor) kullanır).
input_points (`torch.Tensor`, şekli `(batch_size, num_points, 2)`) : Girdi 2B uzamsal noktalar, bu, prompt kodlayıcısının (prompt encoder) prompt'u kodlamak için kullanır. Genel olarak çok daha iyi sonuçlar verir. Noktalar, işlemciye (processor) liste içi liste içi liste geçirilerek elde edilebilir; işlemci, 4 boyutlu karşılık gelen `torch` tensörlerini oluşturur. İlk boyut, görüntü parti boyutudur (image batch size); ikinci boyut, nokta parti boyutudur (yani girdi noktası başına modelden kaç segmentasyon maskesi tahmin etmesini istiyoruz); üçüncü boyut, segmentasyon maskesi başına nokta sayısıdır (tek bir maske için birden fazla nokta geçirmek mümkündür) ve son boyut, noktanın x (dikey) ve y (yatay) koordinatlarıdır. Her görüntü için veya her maske için farklı sayıda nokta geçirilirse, işlemci (0, 0) koordinatına karşılık gelen "PAD" noktaları oluşturur ve etiketler kullanılarak bu noktalar için gömme (embedding) hesabı atlanır.
input_labels (`torch.LongTensor`, şekli `(batch_size, point_batch_size, num_points)`) : Noktalar için giriş etiketleri, bu, prompt kodlayıcısının (prompt encoder) prompt'u kodlamasında kullanılır. Resmi uygulamanın belirttiğine göre 3 tür etiket vardır - `1`: nokta, ilgi nesnesini içeren bir noktadır - `0`: nokta, ilgi nesnesini içermeyen bir noktadır - `-1`: nokta, arka plana karşılık gelir Eklediğimiz etiket: - `-10`: nokta, dolgu (padding) noktasıdır, bu nedenle prompt kodlayıcısı tarafından yok sayılmalıdır Dolgu etiketleri, işlemci (processor) tarafından otomatik olarak yapılmalıdır.
input_boxes (`torch.Tensor`, şekli `(batch_size, num_boxes, 4)`) : Noktalar için giriş kutuları, bu, prompt kodlayıcısının prompt'u kodlaması için kullanılır. Genel olarak çok daha iyi üretilen maskeler sağlar. Kutular, işlemciye (processor) liste içi liste içi liste geçirilerek elde edilebilir; bu işlem, her boyutun sırasıyla görüntü parti boyutuna, görüntü başına kutu sayısına ve kutunun sol üst ile sağ alt noktasının koordinatlarına karşılık geldiği bir `torch` tensörü oluşturur. Sıralama (`x1`, `y1`, `x2`, `y2`): - `x1`: giriş kutusunun sol üst noktasının x koordinatı - `y1`: giriş kutusunun sol üst noktasının y koordinatı - `x2`: giriş kutusunun sağ alt noktasının x koordinatı - `y2`: giriş kutusunun sağ alt noktasının y koordinatı
input_masks (`torch.Tensor`, şekli `(batch_size, image_size, image_size)`) : SAM modeli ayrıca segmentasyon maskelerini de girdi olarak kabul eder. Maske, prompt encoder tarafından gömülecek (embed) ve daha sonra mask decoder'a beslenecek olan karşılık gelen bir gömme (embedding) üretecektir. Bu maskelerin kullanıcı tarafından manuel olarak sağlanması gerekir ve şekilleri (`batch_size`, `image_size`, `image_size`) olmalıdır.
image_embeddings (`torch.Tensor`, şekli `(batch_size, output_channels, window_size, window_size)`) : Görsel gömlemeleri (embeddings), bunlar mask çözücü tarafından maskeler ve iou skorları üretmek için kullanılır. Daha bellek verimli hesaplama için kullanıcılar, `pixel_values` yerine önce `get_image_embeddings` yöntemini kullanarak görsel gömlemelerini alabilir ve ardından bunları `forward` yöntemine iletebilir.
multimask_output (`bool`, *isteğe bağlı*) : Orijinal uygulama ve makalede, model her zaman görüntü başına 3 maske (ilgili durumlarda nokta başına / sınırlayıcı kutu başına) üretir. Ancak, `multimask_output=False` parametresini belirleyerek yalnızca "en iyi" maskeye karşılık gelen tek bir maske üretmek mümkündür.
attention_similarity (`torch.Tensor`, *isteğe bağlı*) : [PerSAM](https://huggingface.co/papers/2305.03048)'de tanıtıldığı gibi model kişiselleştirme için kullanıldığında, hedefe yönelik dikkat için mask kodlayıcıya sağlanacak dikkat benzerlik tensörü.
target_embedding (`torch.Tensor`, *isteğe bağlı*) : Model, [PerSAM](https://huggingface.co/papers/2305.03048)'de tanıtıldığı gibi kişiselleştirme için kullanılıyorsa, hedef-antikavram istemciliği için mask çözücüye sağlanacak hedef kavram gömümü.
**Dönüş:** `SamImageSegmentationOutput` veya `tuple(torch.Tensor)`
Yapılandırmaya ([SamConfig](/docs/transformers/main/tr/model_doc/sam#transformers.SamConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşan bir `SamImageSegmentationOutput` veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda).
[SamModel](/docs/transformers/main/tr/model_doc/sam#transformers.SamModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **iou_scores** (`torch.Tensor`, şekli `(batch_size, num_masks)`) -- Tahmin edilen maskelerin iou puanları.
- **pred_masks** (`torch.Tensor`, şekli `(batch_size, num_masks, height, width)`) -- Tahmin edilen düşük çözünürlüklü maskeler. İşlenmesi için işlemcinin (processor) son işlemeye (post-process) tabi tutması gerekir
- **vision_hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`.
Görüntü modelinin her katmanının çıktısındaki gizli durumlar ve isteğe bağlı başlangıç gömme çıktıları.
- **vision_attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
- **mask_decoder_attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnek:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor
>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")
>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
... raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]] # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")
>>> # Get segmentation mask
>>> outputs = model(**inputs)
>>> # Postprocess masks
>>> masks = processor.post_process_masks(
... outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )
```