# Nougat
## Обзор
Модель Nougat была предложена в работе [Nougat: Neural Optical Understanding for Academic Documents](https://huggingface.co/papers/2308.13418) Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic. Nougat использует ту же архитектуру, что и [Donut](donut), а именно image Transformer encoder и autoregressive text Transformer decoder для перевода научных PDF в markdown, что обеспечивает более простой доступ к ним.
Аннотация из статьи следующая:
*Научные знания преимущественно хранятся в книгах и научных журналах, часто в формате PDF. Однако формат PDF приводит к потере семантической информации, особенно в случае математических выражений. Мы предлагаем Nougat (Neural Optical Understanding for Academic Documents) — модель Visual Transformer, выполняющую задачу оптического распознавания символов (OCR) для обработки научных документов в язык разметки, и демонстрируем эффективность нашей модели на новом наборе данных научных документов. Предложенный подход предлагает перспективное решение для повышения доступности научных знаний в цифровую эпоху, закрывая разрыв между документами, читаемыми человеком, и текстом, читаемым машиной. Мы публикуем модели и код, чтобы ускорить будущие работы по распознаванию научного текста.*
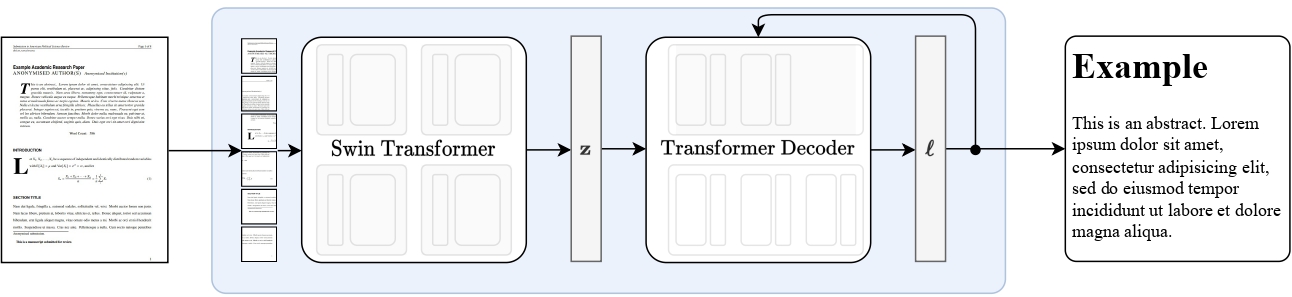 Общий обзор Nougat. Взято из оригинальной статьи.
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/facebookresearch/nougat).
## Советы по использованию
- Самый быстрый способ начать работу с Nougat — это ознакомиться с [учебными ноутбуками](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Nougat), в которых показано, как использовать модель на этапе инференса, а также как выполнять дообучение на собственных данных.
- Nougat всегда используется в рамках фреймворка [VisionEncoderDecoder](vision-encoder-decoder). Архитектура модели идентична архитектуре [Donut](donut).
## Вывод
Модель `VisionEncoderDecoder` Nougat принимает изображения в качестве входных данных и использует [generate()](/docs/transformers/v5.23.0/ru/main_classes/text_generation#transformers.GenerationMixin.generate) для авторегрессионной генерации текста на основе входного изображения.
Класс [NougatImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatImageProcessor) отвечает за предобработку входного изображения, а [NougatTokenizerFast](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatTokenizer) декодирует сгенерированные целевые токены в целевую строку. Класс [NougatProcessor](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatProcessor) объединяет классы [NougatImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatImageProcessor) и [NougatTokenizerFast](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatTokenizer) в единый экземпляр, чтобы извлекать входные признаки и декодировать предсказанные идентификаторы токенов.
- Пошаговая транскрипция PDF
```python
from huggingface_hub import hf_hub_download
from PIL import Image
from transformers import AutoModelForImageTextToText, NougatProcessor
processor = NougatProcessor.from_pretrained("facebook/nougat-base")
model = AutoModelForImageTextToText.from_pretrained("facebook/nougat-base", device_map="auto")
model.to(model.device) # doctest: +IGNORE_RESULT
# prepare PDF image for the model
filepath = hf_hub_download(repo_id="hf-internal-testing/fixtures_docvqa", filename="nougat_paper.png", repo_type="dataset")
image = Image.open(filepath)
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
# generate transcription (here we only generate 30 tokens)
outputs = model.generate(
pixel_values.to(model.device),
min_length=1,
max_new_tokens=30,
bad_words_ids=[[processor.tokenizer.unk_token_id]],
)
sequence = processor.batch_decode(outputs, skip_special_tokens=True)[0]
sequence = processor.post_process_generation(sequence, fix_markdown=False)
# note: we're using repr here such for the sake of printing the \n characters, feel free to just print the sequence
print(repr(sequence))
'\n\n# Nougat: Neural Optical Understanding for Academic Documents\n\n Lukas Blecher\n\nCorrespondence to: lblecher@'
```
Обратитесь к [model hub](https://huggingface.co/models?filter=nougat), чтобы найти чекпоинты Nougat.
Модель идентична [Donut](donut) с точки зрения архитектуры.
## NougatConfig[[transformers.NougatConfig]]
#### transformers.NougatConfig[[transformers.NougatConfig]]
```python
transformers.NougatConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, encoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None, decoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L28)
**Параметры:**
is_encoder_decoder (`bool`, *необязательный*, по умолчанию `True`) : Используется ли модель в качестве энкодера/декодера.
encoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь для базовой модели энкодера.
decoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь для декодерного бэкбона.
Это класс конфигурации для хранения настроек модели NougatModel. Он используется для создания модели Nougat в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [facebook/nougat-base](https://huggingface.co/facebook/nougat-base)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Примеры:
```python
>>> from transformers import NougatConfig, VisionEncoderDecoderModel
>>> # Initializing a Nougat configuration
>>> config = NougatConfig()
>>> # Initializing a VisionEncoderDecoder model (with random weights) from a Nougat configurations
>>> model = VisionEncoderDecoderModel(config=config)
```
#### from_encoder_decoder_configs[[transformers.NougatConfig.from_encoder_decoder_configs]]
```python
from_encoder_decoder_configs(encoder_config: PreTrainedConfig, decoder_config: PreTrainedConfig, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L52)
**Возвращает:** [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/ru/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)
Экземпляр объекта конфигурации
Создайте экземпляр [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/ru/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig) (или производного класса) на основе конфигурации предобученной модели-энкодера и конфигурации модели-декодера.
## NougatImageProcessor[[transformers.NougatImageProcessor]]
#### transformers.NougatImageProcessor[[transformers.NougatImageProcessor]]
```python
transformers.NougatImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L57)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 896, 'width': 672}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_crop_margin (`bool`, *kwargs*, *optional*, по умолчанию `self.do_crop_margin`) : Нужно ли обрезать поля изображения.
do_thumbnail (`bool`, *kwargs*, *optional*, по умолчанию `self.do_thumbnail`) : Использовать ли метод thumbnail для изменения размера изображения.
do_align_long_axis (`bool`, *kwargs*, *optional*, по умолчанию `self.do_align_long_axis`) : Нужно ли выравнивать длинную ось изображения с длинной осью `size` путём поворота на 90 градусов.
Создаёт процессор изображений NougatImageProcessor.
#### preprocess[[transformers.NougatImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L74)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_crop_margin (`bool`, *kwargs*, *optional*, по умолчанию `self.do_crop_margin`) : Нужно ли обрезать поля изображения.
do_thumbnail (`bool`, *kwargs*, *optional*, по умолчанию `self.do_thumbnail`) : Использовать ли метод thumbnail для изменения размера изображения.
do_align_long_axis (`bool`, *kwargs*, *optional*, по умолчанию `self.do_align_long_axis`) : Нужно ли выравнивать длинную ось изображения с длинной осью `size` путём поворота на 90 градусов.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
#### transformers.NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
```python
transformers.NougatImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L59)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 896, 'width': 672}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_crop_margin (`bool`, *kwargs*, *optional*, по умолчанию `self.do_crop_margin`) : Нужно ли обрезать поля изображения.
do_thumbnail (`bool`, *kwargs*, *optional*, по умолчанию `self.do_thumbnail`) : Использовать ли метод thumbnail для изменения размера изображения.
do_align_long_axis (`bool`, *kwargs*, *optional*, по умолчанию `self.do_align_long_axis`) : Нужно ли выравнивать длинную ось изображения с длинной осью `size` путём поворота на 90 градусов.
Создаёт процессор изображений NougatImageProcessor.
#### preprocess[[transformers.NougatImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L76)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_crop_margin (`bool`, *kwargs*, *optional*, по умолчанию `self.do_crop_margin`) : Нужно ли обрезать поля изображения.
do_thumbnail (`bool`, *kwargs*, *optional*, по умолчанию `self.do_thumbnail`) : Использовать ли метод thumbnail для изменения размера изображения.
do_align_long_axis (`bool`, *kwargs*, *optional*, по умолчанию `self.do_align_long_axis`) : Нужно ли выравнивать длинную ось изображения с длинной осью `size` путём поворота на 90 градусов.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## NougatTokenizer[[transformers.NougatTokenizer]]
#### transformers.NougatTokenizer[[transformers.NougatTokenizer]]
```python
transformers.NougatTokenizer(errors: str = 'replace', unk_token: str = '', bos_token: str = '
', eos_token: str = '', pad_token: str = '', vocab: str | dict | list | None = None, merges: str | list | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L347)
**Параметры:**
vocab_file (`str`, *необязательный*) : Путь к файлу словаря.
merges_file (`str`, *необязательный*) : Путь к файлу слияний.
tokenizer_file (`str`, *необязательный*) : файл [tokenizers](https://github.com/huggingface/tokenizers) (обычно с расширением .json), содержащий всё необходимое для загрузки токенизатора.
clean_up_tokenization_spaces (`str`, *необязательный*, по умолчанию `False`) : Нужно ли очищать пробелы после декодирования. Очистка заключается в удалении возможных артефактов, таких как лишние пробелы.
unk_token (`str`, *необязательный*, по умолчанию `""`) : Неизвестный токен. Токен, отсутствующий в словаре, не может быть преобразован в ID, вместо этого ему присваивается данный токен.
bos_token (`str`, *необязательный*, по умолчанию `""`) : Токен начала последовательности, использовавшийся во время предварительного обучения. Может использоваться в качестве токена классификатора последовательности.
eos_token (`str`, *необязательный*, по умолчанию `""`) : Токен конца последовательности.
pad_token (`str`, *необязательный*, по умолчанию `""`) : токен, используемый для выравнивания, например, при пакетной обработке последовательностей разной длины.
vocab (`str`, `dict` или `list`, *необязательный*) : Пользовательский словарь. Если не указан, словарь загружается из vocab_file.
merges (`str` или `list`, *необязательный*) : Пользовательский список слияний. Если не указан, слияния загружаются из merges_file.
Токенизатор для Nougat (основан на библиотеке HuggingFace tokenizers).
Этот токенизатор наследуется от [TokenizersBackend](/docs/transformers/v5.23.0/ru/main_classes/tokenizer#transformers.TokenizersBackend), который содержит большинство основных методов. За дополнительной информацией об этих методах пользователям следует обращаться к этому суперклассу. Данный класс в основном добавляет специфичные для Nougat методы для постобработки сгенерированного текста.
#### correct_tables[[transformers.NougatTokenizer.correct_tables]]
```python
correct_tables(generation: str)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L493)
**Параметры:**
generation (str) : Сгенерированный текст для постобработки.
**Возвращает:** `str`
Постобработанный текст.
Принимает сгенерированную строку и исправляет таблицы, чтобы привести их к необходимому формату Markdown.
Пример:
```python
correct_tables("\begin{table} \begin{tabular}{l l} & \ \end{tabular} \end{table}")
"\begin{table}
abular}{l l} & \ \end{tabular}
le}"
```
#### post_process_generation[[transformers.NougatTokenizer.post_process_generation]]
```python
post_process_generation(generation: str | list[str], fix_markdown: bool = True, num_workers: int | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L623)
**Параметры:**
generation (Union[str, list[str]]) : сгенерированный текст или список сгенерированных текстов.
fix_markdown (`bool`, *необязательный*, по умолчанию `True`) : Выполнять ли исправления форматирования Markdown.
num_workers (`int`, *optional*) : Необязательное количество рабочих процессов для использования многопоточности (обработка нескольких текстов параллельно).
**Возвращает:** Union[str, list[str]]
Постобработанный текст или список постобработанных текстов.
Постобработка сгенерированного текста или списка сгенерированных текстов.
Эта функция может использоваться для постобработки сгенерированного текста, например, для исправления форматирования Markdown.
Постобработка выполняется довольно медленно, поэтому для ускорения процесса рекомендуется использовать многопоточность.
#### post_process_single[[transformers.NougatTokenizer.post_process_single]]
```python
post_process_single(generation: str, fix_markdown: bool = True)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L528)
**Параметры:**
generation (str) : Сгенерированный текст для постобработки.
fix_markdown (bool, optional) : Выполнять ли исправления форматирования Markdown. По умолчанию True.
**Возвращает:** `str`
Постобработанный текст.
Постобработка одного сгенерированного текста. Регулярные выражения, используемые здесь, взяты непосредственно из статьи авторов Nougat. Эти выражения снабжены комментариями для ясности и в большинстве случаев протестированы end-to-end.
#### remove_hallucinated_references[[transformers.NougatTokenizer.remove_hallucinated_references]]
```python
remove_hallucinated_references(text: str)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L463)
**Параметры:**
text (`str`) : входной текст, содержащий ссылки.
**Возвращает:** `str`
Текст с удалёнными вымышленными ссылками.
Удалите вымышленные или отсутствующие ссылки из текста.
Эта функция находит и удаляет из входного текста ссылки, отмеченные как отсутствующие или галлюцинированные.
## NougatProcessor[[transformers.NougatProcessor]]
#### transformers.NougatProcessor[[transformers.NougatProcessor]]
```python
transformers.NougatProcessor(image_processor, tokenizer)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L24)
**Параметры:**
image_processor (`NougatImageProcessor`) : процессор изображений является обязательным входным параметром.
tokenizer (`NougatTokenizer`) : Токенизатор является обязательным входным параметром.
Создаёт NougatProcessor, который объединяет процессор изображений и токенизатор в единый процессор.
[NougatProcessor](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatProcessor) предоставляет все возможности [NougatImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatImageProcessor) и [NougatTokenizer](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatTokenizer). Подробнее см. в [~NougatImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatImageProcessor) и [~NougatTokenizer](/docs/transformers/v5.23.0/ru/model_doc/nougat#transformers.NougatTokenizer).
#### __call__[[transformers.NougatProcessor.__call__]]
```python
__call__(images = None, text = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L32)
**Параметры:**
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
#### from_pretrained[[transformers.NougatProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1799)
**Параметры:**
pretrained_model_name_or_path (`str` или `os.PathLike`) : Может быть одним из следующих: - строка, *model id* предобученного feature_extractor, размещенного в репозитории моделей на huggingface.co. - путь к *каталогу*, содержащему файл feature extractor, сохраненный с помощью метода [save_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained), например, `./my_model_directory/`. - путь к сохраненному JSON-*файлу* feature extractor, например, `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : Дополнительные именованные аргументы, передаваемые как в [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained), так и в `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`.
Создайте экземпляр процессора, связанного с предобученной моделью.
Этот метод класса просто вызывает метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) экстрактора признаков, метод [ImageProcessingMixin](/docs/transformers/v5.23.0/ru/internal/image_processing_utils#transformers.ImageProcessingMixin) процессора изображений и метод `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` токенизатора. Более подробную информацию см. в строках документации указанных методов.
#### save_pretrained[[transformers.NougatProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1182)
**Параметры:**
save_directory (`str` или `os.PathLike`) : Каталог, в котором будут сохранены JSON-файл экстрактора признаков и файлы токенизатора (каталог будет создан, если он не существует).
push_to_hub (`bool`, *необязательный*, по умолчанию `False`) : Указывает, следует ли после сохранения модели загрузить её в Hugging Face model hub. Репозиторий, в который нужно загрузить модель, можно указать с помощью `repo_id` (по умолчанию используется имя `save_directory` в вашем пространстве имён).
kwargs (`dict[str, Any]`, *необязательный*) : Дополнительные именованные аргументы, передаваемые в метод [push_to_hub()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub).
Сохраняет атрибуты этого процессора (извлекатель признаков, токенизатор и т. д.) в указанную директорию, чтобы его можно было загрузить снова с помощью метода [from_pretrained()](/docs/transformers/v5.23.0/ru/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained).
Этот метод класса просто вызывает [save_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) и [save_pretrained()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained). Подробности см. в строках документации указанных выше методов.
#### batch_decode[[transformers.NougatProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2054)
Этот метод передаёт все свои аргументы в [batch_decode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) класса PreTrainedTokenizer. Подробности см. в docstring этого метода.
#### decode[[transformers.NougatProcessor.decode]]
```python
decode(*args, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2063)
Этот метод передаёт все свои аргументы в [decode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) класса PreTrainedTokenizer. Подробности см. в docstring этого метода.
#### post_process_generation[[transformers.NougatProcessor.post_process_generation]]
```python
post_process_generation(*args, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L40)
Этот метод передаёт все свои аргументы в `~PreTrainedTokenizer.post_process_generation` класса NougatTokenizer. Подробности см. в docstring этого метода.