
PEFT documentation
LoHa
LoHa
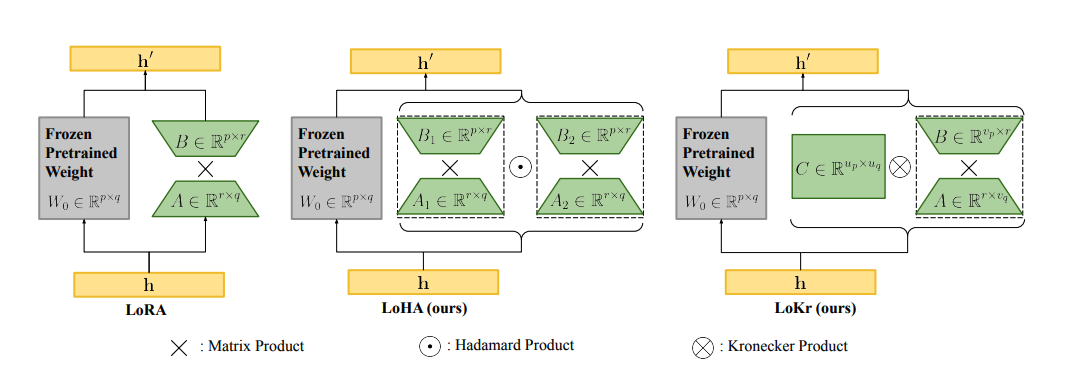
Le produit de Hadamard de rang faible (LoHa) est similaire à LoRA, à l'exception près qu'il approxime la grande matrice de poids avec plusieurs matrices de rang faible et les combine par le produit de Hadamard. Cette méthode est encore plus efficace en termes de paramètres que LoRA et atteint des performances comparables. LoHa a été initialement proposé pour l'apprentissage fédéré (FedPara), mais fonctionne bien comme méthode PEFT générale, et est particulièrement populaire pour l'ajustement fin de modèles de génération d'images tels que Stable Diffusion.
Remarque : LoHa fait partie de la famille d'adaptateurs LyCORIS. Son proche parent LoKr utilise le produit de Kronecker au lieu du produit de Hadamard.
L'abstract de l'article est :
Dans ce travail, nous proposons une paramétrisation efficace en termes de communication, FedPara, pour l'apprentissage fédéré (FL) afin de surmonter les contraintes liées aux téléversements et téléchargements fréquents de modèles. Notre méthode reparamétrise les paramètres de poids des couches en utilisant des poids de faible rang suivis du produit de Hadamard. Par rapport à la paramétrisation de faible rang conventionnelle, notre méthode FedPara n'est pas restreinte aux contraintes de faible rang, et possède donc une capacité bien plus importante. Cette propriété permet d'atteindre des performances comparables tout en nécessitant des coûts de communication 3 à 10 fois inférieurs à ceux du modèle avec les couches d'origine, ce qui n'est pas réalisable par les méthodes de faible rang traditionnelles. L'efficacité de notre méthode peut être encore améliorée en la combinant avec d'autres optimiseurs FL efficaces. De plus, nous étendons notre méthode à une application de FL personnalisé, pFedPara, qui sépare les paramètres en paramètres globaux et locaux. Nous montrons que pFedPara surpasse les méthodes de FL personnalisé concurrentes avec plus de trois fois moins de paramètres.
La décomposition de rang faible peut affecter les performances, car les mises à jour des poids sont limitées à l’espace de rang faible, ce qui peut contraindre l’expressivité d’un modèle. Cependant, il n’est pas nécessairement souhaitable d’utiliser un rang plus élevé, car cela augmente le nombre de paramètres entraînables. Pour remédier à cela, LoHa a été appliqué aux modèles de diffusion, où la capacité à générer des images variées est un aspect important. LoHa devrait également fonctionner avec des types de modèles généraux, mais la prise en charge des couches d’incorporation n’est pas actuellement implémentée dans PEFT.
LoHa utilise le produit de Hadamard (produit élément par élément) au lieu du produit matriciel. est représenté par quatre matrices plus petites au lieu de deux - comme dans LoRA - et chaque paire de ces matrices de faible rang est combinée par le produit de Hadamard. En conséquence, peut avoir le même nombre de paramètres entraînables, mais un rang et une expressivité plus élevés.
Quand utiliser LoHa
LoHa est un bon choix lorsque :
- Vous effectuez l’ajustement fin de modèles de génération d’images (UNet de Stable Diffusion ou encodeur de texte), ce qui en constitue l’usage le plus répandu.
- Vous souhaitez un rang effectif plus élevé que LoRA pour le même nombre de paramètres entraînables, car le produit de Hadamard de deux matrices de faible rang englobe un sous-espace plus large qu’un simple produit de faible rang.
- Vous souhaitez combiner différentes méthodes PEFT lors de l'inférence à l'aide de
PeftMixedModel, par exemple LoHa avec LoKr.
LoHa prend en charge les couches linéaires et Conv2d. Pour les tâches qui nécessitent en plus l'adaptation de la couche d'embedding, envisagez plutôt LoRA.
Utilisation
from diffusers import StableDiffusionPipeline
from peft import LoHaConfig, get_peft_model

config_unet = LoHaConfig(
    r=8,
    alpha=8,
    target_modules=[
        "to_k",
        "to_q",
        "to_v",
        "to_out.0",
        "proj_in",
        "proj_out",
    ],
    rank_dropout=0.0,
    module_dropout=0.0,
    use_effective_conv2d=True,
)

pipeline = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5")
pipeline.unet = get_peft_model(pipeline.unet, config_unet)
pipeline.unet.print_healthcheck()
Aperçu des benchmarks
API
LoHaConfig
classe peft.LoHaConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falserank_pattern: Optional[dict] = <factory>alpha_pattern: Optional[dict] = <factory>r: int = 8alpha: int = 8rank_dropout: float = 0.0module_dropout: float = 0.0use_effective_conv2d: bool = Falsetarget_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = Nonemodules_to_save: Optional[list[str]] = None )
Paramètres
- r (
int) — Rang LoHa. - alpha (
int) — Le paramètre alpha pour le scaling LoHa. - rank_dropout (
float) — Probabilité de dropout pour la dimension de rang pendant l'entraînement. - module_dropout (
float) — Probabilité de dropout pour désactiver les modules LoHa pendant l’entraînement. - use_effective_conv2d (
bool) — Utilise la décomposition effective des paramètres pour Conv2d (et Conv1d) avec ksize > 1 (« Proposition 3 » du papier FedPara). - target_modules (
Optional[Union[List[str], str]]) — Les noms des modules auxquels appliquer l’adaptateur. Si ce paramètre est spécifié, seuls les modules portant les noms indiqués seront remplacés. En cas de chaîne de caractères, une correspondance par expression régulière est effectuée. En cas de liste de chaînes de caractères, une correspondance exacte est réalisée ou il est vérifié si le nom du module se termine par l’une des chaînes fournies. Si la valeur est « all-linear », tous les modules linéaires/Conv1D sont sélectionnés, à l’exception de la couche de sortie. Si ce paramètre n’est pas spécifié, les modules sont choisis en fonction de l’architecture du modèle. Si l’architecture est inconnue, une erreur est levée — dans ce cas, vous devez spécifier manuellement les modules cibles. - exclude_modules (
Optional[Union[List[str], str]]) — Les noms des modules auxquels l’adaptateur ne doit pas être appliqué. Si une chaîne de caractères est transmise, une correspondance par expression régulière est effectuée. Si une liste de chaînes de caractères est transmise, une correspondance exacte est effectuée ou il est vérifié si le nom du module se termine par l’une des chaînes transmises. - init_weights (
bool) — Indique s'il faut effectuer l'initialisation des poids de l'adaptateur. La valeur par défaut estTrue; passerFalseest déconseillé. - layers_to_transform (
Union[List[int], int]) — Les indices de couches à transformer. Si une liste d'entiers est transmise, l'adaptateur sera appliqué aux indices de couches spécifiés dans cette liste. Si un seul entier est transmis, les transformations seront appliquées à la couche située à cet index. - layers_pattern (
Optional[Union[List[str], str]]) — Le nom du motif de couche, utilisé uniquement silayers_to_transformest différent deNone. Il doit cibler lenn.ModuleListdu modèle, souvent appelé'layers'ou'h'. - rank_pattern (
dict) — La correspondance entre les noms de couches ou les expressions régulières et les rangs qui diffèrent du rang par défaut spécifié parr. Par exemple,{'^model.decoder.layers.0.encoder_attn.k_proj': 16}. - alpha_pattern (
dict) — La correspondance entre les noms de couches ou les expressions régulières et les alphas qui diffèrent de l'alpha par défaut spécifié paralpha. Par exemple,{'^model.decoder.layers.0.encoder_attn.k_proj': 16}. - modules_to_save (
Optional[List[str]]) — Liste des modules, autres que les couches d’adaptateur, à définir comme entraînables et à enregistrer dans le point de contrôle final.
Ceci est la classe de configuration destinée à stocker la configuration d'un LoHaModel.
LoHaModel
classe peft.LoHaModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Paramètres
- model (
torch.nn.Module) — Le modèle auquel les couches d’adaptation du tuner seront attachées. - config (LoHaConfig) — La configuration du modèle LoHa.
- adapter_name (
str) — Le nom de l'adaptateur, par défaut"default". - low_cpu_mem_usage (
bool,optional, par défautFalse) — Crée des poids d'adaptateurs vides sur l'appareil méta. Utile pour accélérer le processus de chargement.
Retourne
torch.nn.Module
Le modèle LoHa.
Crée un modèle Low-Rank Hadamard Product à partir d'un modèle pré-entraîné. La méthode est partiellement décrite dans https://huggingface.co/papers/2108.06098 L'implémentation actuelle s'inspire largement de https://github.com/KohakuBlueleaf/LyCORIS/blob/eb460098187f752a5d66406d3affade6f0a07ece/lycoris/modules/loha.py
Exemple :
>>> from diffusers import StableDiffusionPipeline
>>> from peft import LoHaModel, LoHaConfig

>>> config_te = LoHaConfig(
...     r=8,
...     lora_alpha=32,
...     target_modules=["k_proj", "q_proj", "v_proj", "out_proj", "fc1", "fc2"],
...     rank_dropout=0.0,
...     module_dropout=0.0,
...     init_weights=True,
... )
>>> config_unet = LoHaConfig(
...     r=8,
...     lora_alpha=32,
...     target_modules=[
...         "proj_in",
...         "proj_out",
...         "to_k",
...         "to_q",
...         "to_v",
...         "to_out.0",
...         "ff.net.0.proj",
...         "ff.net.2",
...     ],
...     rank_dropout=0.0,
...     module_dropout=0.0,
...     init_weights=True,
...     use_effective_conv2d=True,
... )

>>> model = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5")
>>> model.text_encoder = LoHaModel(model.text_encoder, config_te, "default")
>>> model.unet = LoHaModel(model.unet, config_unet, "default")
Attributs :
- model (
~torch.nn.Module) — Le modèle à adapter. - peft_config (LoHaConfig) : La configuration du modèle LoHa.