
PEFT documentation
DeepSpeed
DeepSpeed
DeepSpeed é uma biblioteca projetada para velocidade e escala no treinamento distribuído de modelos grandes com bilhões de parâmetros. Em seu núcleo está o Zero Redundancy Optimizer (ZeRO), que divide os estados do otimizador (ZeRO-1), os gradientes (ZeRO-2) e os parâmetros (ZeRO-3) entre processos paralelos de dados. Isso reduz drasticamente o uso de memória, permitindo que você escale seu treinamento para modelos com bilhões de parâmetros. Para desbloquear ainda mais eficiência de memória, o ZeRO-Offload reduz o cálculo e a memória da GPU aproveitando os recursos da CPU durante a otimização.
Ambas essas funcionalidades são suportadas no 🤗 Accelerate e você pode usá-las com o 🤗 PEFT.
Compatibilidade com quantização bitsandbytes + LoRA
Abaixo está uma tabela que resume a compatibilidade entre o LoRA do PEFT, a biblioteca bitsandbytes e os estágios Zero do DeepSpeed em relação ao fine-tuning. O DeepSpeed Zero-1 e 2 não terão efeito na inferência, pois o estágio 1 faz o sharding dos estados do otimizador e o estágio 2 faz o sharding dos estados do otimizador e dos gradientes:
| Etapa do DeepSpeed | É compatível? |
|---|---|
| Zero-1 | 🟢 |
| Zero-2 | 🟢 |
| Zero-3 | 🟢 |
Para DeepSpeed Stage 3 + QLoRA, consulte a seção Use PEFT QLoRA and DeepSpeed with ZeRO3 for finetuning large models on multiple GPUs abaixo.
Para confirmar essas observações, executamos os scripts de exemplo oficiais de SFT (Supervised Fine-tuning) da Transformers Reinforcement Learning (TRL) library usando QLoRA + PEFT e os configs do accelerate disponíveis aqui. Executamos esses experimentos em uma GPU 2x NVIDIA T4.
Use PEFT e DeepSpeed com ZeRO3 para ajuste fino de modelos grandes em vários dispositivos e vários nós
Esta seção do guia ajudará você a aprender como usar nosso script de treinamento do DeepSpeed para realizar SFT. Você configurará o script para executar SFT (ajuste fino supervisionado) do modelo Llama-70B com LoRA e ZeRO-3 em 8 GPUs H100 de 80GB em uma única máquina. Você pode configurá-lo para escalar para múltiplas máquinas alterando a configuração do accelerate.
Configuração
Comece executando o seguinte comando para criar um arquivo de configuração do DeepSpeed com o 🤗 Accelerate. A flag --config_file permite salvar o arquivo de configuração em um local específico; caso contrário, ele é salvo como um arquivo default_config.yaml no cache do 🤗 Accelerate.
O arquivo de configuração é usado para definir as opções padrão ao iniciar o script de treinamento.
accelerate config --config_file deepspeed_config.yaml
Você será solicitado a responder algumas perguntas sobre sua configuração e a configurar os seguintes argumentos. Neste exemplo, você usará o ZeRO-3, portanto, certifique-se de selecionar essas opções.
`zero_stage`: [0] Disabled, [1] optimizer state partitioning, [2] optimizer+gradient state partitioning and [3] optimizer+gradient+parameter partitioning
`gradient_accumulation_steps`: Number of training steps to accumulate gradients before averaging and applying them. Pass the same value as you would pass via cmd argument else you will encounter mismatch error.
`gradient_clipping`: Enable gradient clipping with value. Don't set this as you will be passing it via cmd arguments.
`offload_optimizer_device`: [none] Disable optimizer offloading, [cpu] offload optimizer to CPU, [nvme] offload optimizer to NVMe SSD. Only applicable with ZeRO >= Stage-2. Set this as `none` as don't want to enable offloading.
`offload_param_device`: [none] Disable parameter offloading, [cpu] offload parameters to CPU, [nvme] offload parameters to NVMe SSD. Only applicable with ZeRO Stage-3. Set this as `none` as don't want to enable offloading.
`zero3_init_flag`: Decides whether to enable `deepspeed.zero.Init` for constructing massive models. Only applicable with ZeRO Stage-3. Set this to `True`.
`zero3_save_16bit_model`: Decides whether to save 16-bit model weights when using ZeRO Stage-3. Set this to `True`.
`mixed_precision`: `no` for FP32 training, `fp16` for FP16 mixed-precision training and `bf16` for BF16 mixed-precision training. Set this to `True`.
Uma vez concluído, a configuração correspondente deve se parecer com a abaixo e pode ser encontrada na pasta de configuração em deepspeed_config.yaml:
compute_environment: LOCAL_MACHINE
debug: false
deepspeed_config:
  deepspeed_multinode_launcher: standard
  gradient_accumulation_steps: 4
  offload_optimizer_device: none
  offload_param_device: none
  zero3_init_flag: true
  zero3_save_16bit_model: true
  zero_stage: 3
distributed_type: DEEPSPEED
downcast_bf16: 'no'
machine_rank: 0
main_training_function: main
mixed_precision: bf16
num_machines: 1
num_processes: 8
rdzv_backend: static
same_network: true
tpu_env: []
tpu_use_cluster: false
tpu_use_sudo: false
use_cpu: false
Comando de inicialização
O comando de inicialização está disponível em run_peft_deepspeed.sh e também é mostrado abaixo:
accelerate launch --config_file "configs/deepspeed_config.yaml"  train.py \
--seed 100 \
--model_name_or_path "meta-llama/Llama-2-70b-hf" \
--dataset_name "smangrul/ultrachat-10k-chatml" \
--chat_template_format "chatml" \
--add_special_tokens False \
--append_concat_token False \
--splits "train,test" \
--max_seq_len 2048 \
--num_train_epochs 1 \
--logging_steps 5 \
--log_level "info" \
--logging_strategy "steps" \
--eval_strategy "epoch" \
--save_strategy "epoch" \
--push_to_hub \
--hub_private_repo True \
--hub_strategy "every_save" \
--bf16 True \
--packing True \
--learning_rate 1e-4 \
--lr_scheduler_type "cosine" \
--weight_decay 1e-4 \
--warmup_steps 0 \
--max_grad_norm 1.0 \
--output_dir "llama-sft-lora-deepspeed" \
--per_device_train_batch_size 8 \
--per_device_eval_batch_size 8 \
--gradient_accumulation_steps 4 \
--gradient_checkpointing True \
--use_reentrant False \
--dataset_text_field "content" \
--use_flash_attn True \
--use_peft_lora True \
--lora_r 8 \
--lora_alpha 16 \
--lora_dropout 0.1 \
--lora_target_modules "all-linear" \
--use_4bit_quantization False
Observe que estamos usando LoRA com rank=8, alpha=16 e direcionando para todas as camadas lineares. Estamos passando o arquivo de configuração do DeepSpeed e fazendo o ajuste fino do modelo Llama de 70B em um subconjunto do conjunto de dados ultrachat.
As partes importantes
Vamos mergulhar um pouco mais no script para que você possa ver o que está acontecendo e entender como ele funciona.
A primeira coisa a saber é que o script usa DeepSpeed para treinamento distribuído, pois a configuração do DeepSpeed foi passada. A classe SFTTrainer cuida de todo o trabalho pesado de criar o modelo PEFT usando a configuração peft que é passada. Depois disso, quando você chama trainer.train(), o SFTTrainer usa internamente o 🤗 Accelerate para preparar o modelo, o otimizador e o treinador, usando a configuração do DeepSpeed para criar o motor DeepSpeed, que então é treinado. O trecho principal de código está abaixo:
# trainer
trainer = SFTTrainer(
    model=model,
    processing_class=tokenizer,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    peft_config=peft_config,
)
trainer.accelerator.print(f"{trainer.model}")

# train
checkpoint = None
if training_args.resume_from_checkpoint is not None:
    checkpoint = training_args.resume_from_checkpoint
trainer.train(resume_from_checkpoint=checkpoint)

# saving final model
trainer.save_model()
Uso de memória
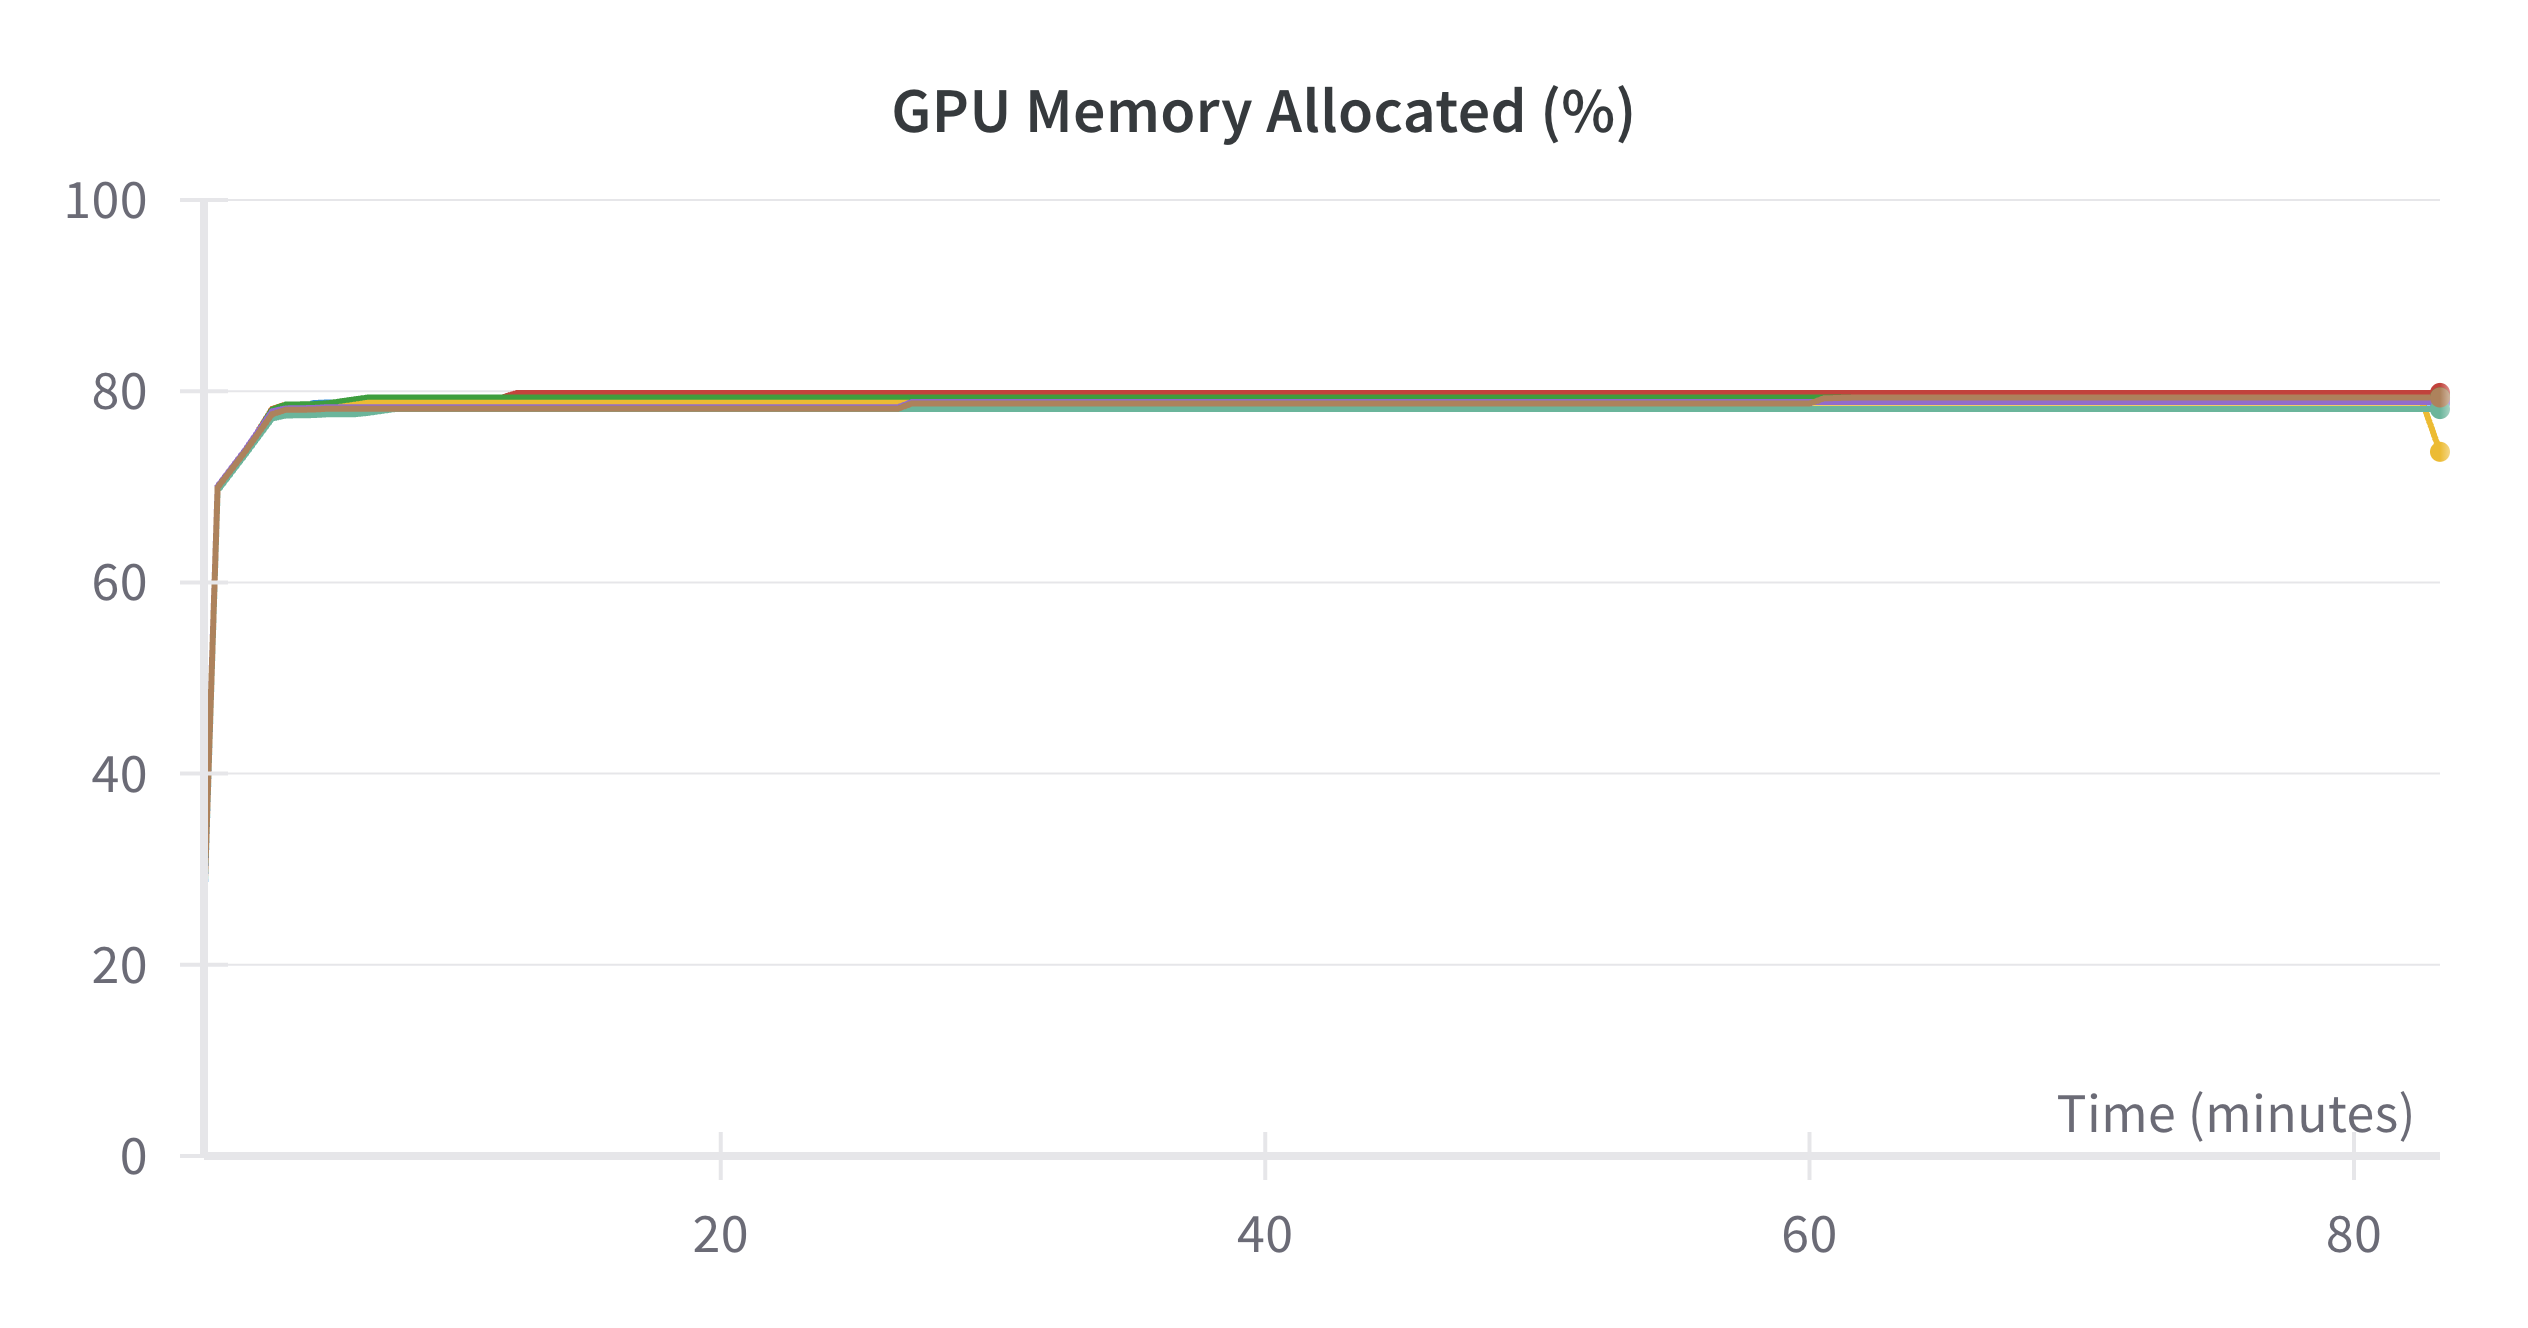
No exemplo acima, a memória consumida por GPU é de 64 GB (80%), conforme visto no screenshot abaixo:
Mais recursos
Você também pode consultar este post no blog Falcon 180B Finetuning using 🤗 PEFT and DeepSpeed sobre como fazer o finetuning do modelo Falcon 180B em 16 GPUs A100 em 2 máquinas.
Use PEFT QLoRA e DeepSpeed com ZeRO3 para ajuste fino de modelos grandes em várias GPUs
Nesta seção, veremos como usar QLoRA e DeepSpeed Stage-3 para fazer o finetuning do modelo llama de 70B em 2 GPUs de 40GB.
Para isso, primeiro precisamos de bitsandbytes>=0.43.3, accelerate>=1.0.1, transformers>4.44.2, trl>0.11.4 e peft>0.13.0. Precisamos definir zero3_init_flag como true ao usar a configuração do Accelerate. Abaixo está a configuração que pode ser encontrada em deepspeed_config_z3_qlora.yaml:
compute_environment: LOCAL_MACHINE
debug: false
deepspeed_config:
  deepspeed_multinode_launcher: standard
  offload_optimizer_device: none
  offload_param_device: none
  zero3_init_flag: true
  zero3_save_16bit_model: true
  zero_stage: 3
distributed_type: DEEPSPEED
downcast_bf16: 'no'
machine_rank: 0
main_training_function: main
mixed_precision: bf16
num_machines: 1
num_processes: 2
rdzv_backend: static
same_network: true
tpu_env: []
tpu_use_cluster: false
tpu_use_sudo: false
use_cpu: false
O comando de lançamento é apresentado abaixo e está disponível em run_peft_qlora_deepspeed_stage3.sh:
accelerate launch --config_file "configs/deepspeed_config_z3_qlora.yaml"  train.py \
--seed 100 \
--model_name_or_path "meta-llama/Llama-2-70b-hf" \
--dataset_name "smangrul/ultrachat-10k-chatml" \
--chat_template_format "chatml" \
--add_special_tokens False \
--append_concat_token False \
--splits "train,test" \
--max_seq_len 2048 \
--num_train_epochs 1 \
--logging_steps 5 \
--log_level "info" \
--logging_strategy "steps" \
--eval_strategy "epoch" \
--save_strategy "epoch" \
--push_to_hub \
--hub_private_repo True \
--hub_strategy "every_save" \
--bf16 True \
--packing True \
--learning_rate 1e-4 \
--lr_scheduler_type "cosine" \
--weight_decay 1e-4 \
--warmup_steps 0 \
--max_grad_norm 1.0 \
--output_dir "llama-sft-qlora-dsz3" \
--per_device_train_batch_size 2 \
--per_device_eval_batch_size 2 \
--gradient_accumulation_steps 2 \
--gradient_checkpointing True \
--use_reentrant True \
--dataset_text_field "content" \
--use_flash_attn True \
--use_peft_lora True \
--lora_r 8 \
--lora_alpha 16 \
--lora_dropout 0.1 \
--lora_target_modules "all-linear" \
--use_4bit_quantization True \
--use_nested_quant True \
--bnb_4bit_compute_dtype "bfloat16" \
--bnb_4bit_quant_storage_dtype "bfloat16"
Observe o novo argumento sendo passado bnb_4bit_quant_storage_dtype, que denota o tipo de dados para empacotar os parâmetros de 4 bits. Por exemplo, quando definido como bfloat16, 32/4 = 8 parâmetros de 4 bits são empacotados juntos após a quantização.
Em termos de código de treinamento, as alterações importantes no código são:
...

bnb_config = BitsAndBytesConfig(
    load_in_4bit=args.use_4bit_quantization,
    bnb_4bit_quant_type=args.bnb_4bit_quant_type,
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=args.use_nested_quant,
+   bnb_4bit_quant_storage=quant_storage_dtype,
)

...

model = AutoModelForCausalLM.from_pretrained(
    args.model_name_or_path,
    quantization_config=bnb_config,
    trust_remote_code=True,
    attn_implementation="flash_attention_2" if args.use_flash_attn else "eager",
+   dtype=quant_storage_dtype or torch.float32,
)
Observe que o dtype de AutoModelForCausalLM é o mesmo que o tipo de dados bnb_4bit_quant_storage. É isso. Tudo o mais é tratado pelo Trainer e pelo TRL.
Uso de memória
No exemplo acima, a memória consumida por GPU é de 36,6 GB. Portanto, o que exigia 8 GPUs de 80GB com DeepSpeed Stage 3+LoRA e algumas GPUs de 80GB com DDP+QLoRA agora requer apenas 2 GPUs de 40GB. Isso torna o ajuste fino de modelos grandes mais acessível.
Use PEFT e DeepSpeed com ZeRO3 e CPU Offloading para fazer o ajuste fino de modelos grandes em uma única GPU
Esta seção do guia ajudará você a aprender como usar nosso script de treinamento do DeepSpeed. Você configurará o script para treinar um modelo grande para geração condicional com ZeRO-3 e CPU Offload.
💡 Para ajudá-lo a começar, confira nossos scripts de exemplo de treinamento para modelagem de linguagem causal e geração condicional. Você pode adaptar esses scripts para suas próprias aplicações ou até mesmo usá-los diretamente, caso sua tarefa seja semelhante à dos scripts.
Configuração
Comece executando o seguinte comando para criar um arquivo de configuração do DeepSpeed com o 🤗 Accelerate. A flag --config_file permite salvar o arquivo de configuração em um local específico; caso contrário, ele é salvo como um arquivo default_config.yaml no cache do 🤗 Accelerate.
O arquivo de configuração é usado para definir as opções padrão ao iniciar o script de treinamento.
accelerate config --config_file ds_zero3_cpu.yaml
Você será solicitado a responder algumas perguntas sobre sua configuração e a configurar os seguintes argumentos. Neste exemplo, você usará o ZeRO-3 junto com o CPU-Offload, portanto, certifique-se de selecionar essas opções.
`zero_stage`: [0] Disabled, [1] optimizer state partitioning, [2] optimizer+gradient state partitioning and [3] optimizer+gradient+parameter partitioning
`gradient_accumulation_steps`: Number of training steps to accumulate gradients before averaging and applying them.
`gradient_clipping`: Enable gradient clipping with value.
`offload_optimizer_device`: [none] Disable optimizer offloading, [cpu] offload optimizer to CPU, [nvme] offload optimizer to NVMe SSD. Only applicable with ZeRO >= Stage-2.
`offload_param_device`: [none] Disable parameter offloading, [cpu] offload parameters to CPU, [nvme] offload parameters to NVMe SSD. Only applicable with ZeRO Stage-3.
`zero3_init_flag`: Decides whether to enable `deepspeed.zero.Init` for constructing massive models. Only applicable with ZeRO Stage-3.
`zero3_save_16bit_model`: Decides whether to save 16-bit model weights when using ZeRO Stage-3.
`mixed_precision`: `no` for FP32 training, `fp16` for FP16 mixed-precision training and `bf16` for BF16 mixed-precision training.
Um exemplo de arquivo de configuração pode ser o seguinte. O mais importante a observar é que zero_stage está definido como 3, e offload_optimizer_device e offload_param_device estão definidos como cpu.
compute_environment: LOCAL_MACHINE
deepspeed_config:
  gradient_accumulation_steps: 1
  gradient_clipping: 1.0
  offload_optimizer_device: cpu
  offload_param_device: cpu
  zero3_init_flag: true
  zero3_save_16bit_model: true
  zero_stage: 3
distributed_type: DEEPSPEED
downcast_bf16: 'no'
dynamo_backend: 'NO'
fsdp_config: {}
machine_rank: 0
main_training_function: main
megatron_lm_config: {}
mixed_precision: 'no'
num_machines: 1
num_processes: 1
rdzv_backend: static
same_network: true
use_cpu: false
As partes importantes
Vamos mergulhar um pouco mais no script para que você possa ver o que está acontecendo e entender como ele funciona.
Dentro da função main, o script cria uma classe Accelerator para inicializar todos os requisitos necessários para o treinamento distribuído.
💡 Sinta-se à vontade para alterar o modelo e o conjunto de dados dentro da função
main. Se o formato do seu conjunto de dados for diferente do presente no script, você também pode precisar de escrever sua própria função de pré-processamento.
O script também cria uma configuração para o método 🤗 PEFT que você está usando, que, neste caso, é o LoRA. O LoraConfig especifica o tipo de tarefa e parâmetros importantes, como a dimensão das matrizes de baixo posto, o fator de escala das matrizes e a probabilidade de dropout das camadas LoRA. Se você quiser usar um método 🤗 PEFT diferente, certifique-se de substituir LoraConfig pela classe apropriada.
 def main():
+    accelerator = Accelerator()
     model_name_or_path = "facebook/bart-large"
     dataset_name = "twitter_complaints"
+    peft_config = LoraConfig(
         task_type=TaskType.SEQ_2_SEQ_LM, inference_mode=False, r=8, lora_alpha=32, lora_dropout=0.1
     )
Ao longo do script, você verá as funções main_process_first e wait_for_everyone, que ajudam a controlar e sincronizar quando os processos são executados.
A função get_peft_model() recebe um modelo base e o peft_config que você preparou anteriormente para criar um PeftModel:
  model = AutoModelForSeq2SeqLM.from_pretrained(model_name_or_path)
+ model = get_peft_model(model, peft_config)
Passe todos os objetos de treinamento relevantes para o prepare do 🤗 Accelerate, que garante que tudo esteja pronto para o treinamento:
model, train_dataloader, eval_dataloader, test_dataloader, optimizer, lr_scheduler = accelerator.prepare(
    model, train_dataloader, eval_dataloader, test_dataloader, optimizer, lr_scheduler
)
O próximo trecho de código verifica se o plugin DeepSpeed é usado no Accelerator e, se o plugin existir, verifica se estamos usando ZeRO-3. Essa flag condicional é usada ao chamar a função generate durante a inferência para sincronizar as GPUs quando os parâmetros do modelo estão fragmentados:
is_ds_zero_3 = False
if getattr(accelerator.state, "deepspeed_plugin", None):
    is_ds_zero_3 = accelerator.state.deepspeed_plugin.zero_stage == 3
Dentro do loop de treinamento, o usual loss.backward() é substituído pelo backward do 🤗 Accelerate, que usa o método backward() correto com base na sua configuração:
  for epoch in range(num_epochs):
      with TorchTracemalloc() as tracemalloc:
          model.train()
          total_loss = 0
          for step, batch in enumerate(tqdm(train_dataloader)):
              outputs = model(**batch)
              loss = outputs.loss
              total_loss += loss.detach().float()
+             accelerator.backward(loss)
              optimizer.step()
              lr_scheduler.step()
              optimizer.zero_grad()
É isso! O restante do script trata do loop de treinamento, da avaliação e até mesmo faz o push para o Hub por você.
Treinar
Execute o seguinte comando para iniciar o script de treinamento. Anteriormente, você salvou o arquivo de configuração em ds_zero3_cpu.yaml, portanto, será necessário passar o caminho para o launcher com o argumento --config_file da seguinte forma:
accelerate launch --config_file ds_zero3_cpu.yaml examples/conditional_generation/peft_lora_seq2seq_accelerate_ds_zero3_offload.py
Você verá alguns logs de saída que acompanham o uso de memória durante o treinamento e, uma vez concluído, o script retorna a acurácia e compara as previsões com os rótulos:
GPU Memory before entering the train : 1916
GPU Memory consumed at the end of the train (end-begin): 66
GPU Peak Memory consumed during the train (max-begin): 7488
GPU Total Peak Memory consumed during the train (max): 9404
CPU Memory before entering the train : 19411
CPU Memory consumed at the end of the train (end-begin): 0
CPU Peak Memory consumed during the train (max-begin): 0
CPU Total Peak Memory consumed during the train (max): 19411
epoch=4: train_ppl=tensor(1.0705, device='cuda:0') train_epoch_loss=tensor(0.0681, device='cuda:0')
100%|████████████████████████████████████████████████████████████████████████████████████████████| 7/7 [00:27<00:00,  3.92s/it]
GPU Memory before entering the eval : 1982
GPU Memory consumed at the end of the eval (end-begin): -66
GPU Peak Memory consumed during the eval (max-begin): 672
GPU Total Peak Memory consumed during the eval (max): 2654
CPU Memory before entering the eval : 19411
CPU Memory consumed at the end of the eval (end-begin): 0
CPU Peak Memory consumed during the eval (max-begin): 0
CPU Total Peak Memory consumed during the eval (max): 19411
accuracy=100.0
eval_preds[:10]=['no complaint', 'no complaint', 'complaint', 'complaint', 'no complaint', 'no complaint', 'no complaint', 'complaint', 'complaint', 'no complaint']
dataset['train'][label_column][:10]=['no complaint', 'no complaint', 'complaint', 'complaint', 'no complaint', 'no complaint', 'no complaint', 'complaint', 'complaint', 'no complaint']
Observações
- A fusão ao usar PEFT e DeepSpeed não é suportada no momento e resultará em um erro.
- Ao usar o offloading de CPU, os principais ganhos obtidos ao usar PEFT para reduzir os estados do otimizador e os gradientes para o tamanho dos pesos do adaptador seriam realizados na RAM da CPU e não haveria economia em relação à memória da GPU.
- O uso de DeepSpeed Stage 3 e qlora com offloading para CPU resulta em maior uso de memória de GPU em comparação com o desligamento do offloading para CPU.
Update on GitHub💡 Quando você tem código que requer a fusão (e desfusão) de pesos, tente coletar manualmente os parâmetros com DeepSpeed Zero-3 antes:
import deepspeed

is_ds_zero_3 = ... # check if Zero-3

with deepspeed.zero.GatheredParameters(list(model.parameters()), enabled= is_ds_zero_3):
    model.merge_adapter()
    # do whatever is needed, then unmerge in the same context if unmerging is required
    ...
    model.unmerge_adapter()