
PEFT documentation
LoHa
LoHa
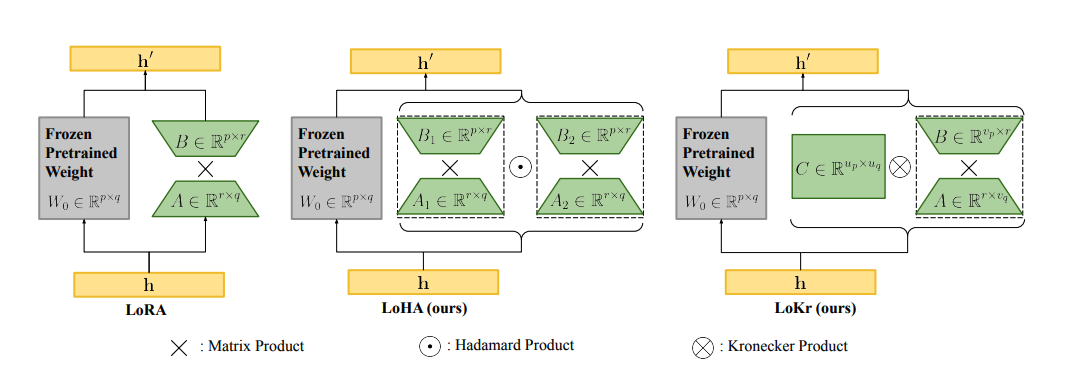
Tích Hadamard hạng thấp (LoHa) tương tự như LoRA, ngoại trừ việc nó xấp xỉ ma trận trọng số lớn bằng nhiều ma trận hạng thấp hơn và kết hợp chúng bằng tích Hadamard. Phương pháp này còn hiệu quả về tham số hơn LoRA và đạt được hiệu suất tương đương. LoHa ban đầu được đề xuất cho học liên bang (FedPara) nhưng hoạt động tốt như một phương pháp PEFT đa dụng, và đặc biệt phổ biến để tinh chỉnh các mô hình tạo hình ảnh như Stable Diffusion.
Lưu ý: LoHa là một phần của họ adapter LyCORIS. Người họ hàng gần của nó, LoKr, sử dụng tích Kronecker thay vì tích Hadamard.
Tóm tắt từ bài báo là:
Trong công trình này, chúng tôi đề xuất một phương pháp tham số hóa hiệu quả về mặt truyền thông, FedPara, cho học liên kết (FL) nhằm khắc phục gánh nặng do việc tải lên và tải xuống mô hình thường xuyên gây ra. Phương pháp của chúng tôi tham số hóa lại các tham số trọng số của các lớp bằng cách sử dụng trọng số hạng thấp, sau đó áp dụng tích Hadamard. So với phương pháp tham số hóa hạng thấp thông thường, phương pháp FedPara của chúng tôi không bị giới hạn bởi các ràng buộc hạng thấp, do đó có dung lượng lớn hơn rất nhiều. Đặc tính này cho phép đạt được hiệu suất tương đương trong khi yêu cầu chi phí truyền thông thấp hơn từ 3 đến 10 lần so với mô hình có các lớp gốc, điều mà các phương pháp hạng thấp truyền thống không thể đạt được. Hiệu quả của phương pháp chúng tôi có thể được cải thiện thêm bằng cách kết hợp với các bộ tối ưu FL hiệu quả khác. Ngoài ra, chúng tôi mở rộng phương pháp của mình sang ứng dụng FL cá nhân hóa, pFedPara, trong đó tách các tham số thành tham số toàn cục và tham số cục bộ. Chúng tôi chỉ ra rằng pFedPara vượt trội hơn so với các phương pháp FL cá nhân hóa cạnh tranh với số lượng tham số ít hơn hơn ba lần.
Phân rã hạng thấp có thể ảnh hưởng đến hiệu suất vì các bản cập nhật trọng số bị giới hạn trong không gian hạng thấp, điều này có thể hạn chế khả năng biểu đạt của mô hình. Tuy nhiên, bạn không nhất thiết nên sử dụng hạng lớn hơn vì nó làm tăng số lượng tham số có thể huấn luyện. Để giải quyết vấn đề này, LoHa đã được áp dụng cho các mô hình khuếch tán, nơi khả năng tạo ra các hình ảnh đa dạng là một yếu tố quan trọng. LoHa cũng nên hoạt động với các loại mô hình nói chung, nhưng hỗ trợ cho các lớp nhúng (embedding layers) hiện chưa được triển khai trong PEFT.
LoHa sử dụng tích Hadamard ((tích từng phần tử) thay vì tích ma trận. được biểu diễn bằng bốn ma trận nhỏ hơn thay vì hai - giống như trong LoRA - và mỗi cặp ma trận hạng thấp này được kết hợp bằng tích Hadamard. Kết quả là, có thể có cùng số tham số huấn luyện được nhưng hạng và khả năng biểu diễn cao hơn.
Khi nào nên sử dụng LoHa
LoHa là một lựa chọn tốt khi:
- Bạn đang tinh chỉnh mô hình tạo ảnh (Stable Diffusion UNet hoặc text encoder), nơi nó được sử dụng phổ biến nhất.
- Bạn muốn hạng hiệu dụng cao hơn so với LoRA khi cùng số tham số có thể huấn luyện, vì tích Hadamard của hai ma trận hạng thấp bao phủ một không gian con lớn hơn so với một tích hạng thấp đơn lẻ.
- Bạn muốn kết hợp các phương pháp PEFT khác nhau khi suy luận bằng
PeftMixedModel, ví dụ như LoHa cùng với LoKr.
LoHa hỗ trợ các lớp linear và Conv2d. Đối với các tác vụ cần thêm thích ứng lớp embedding, hãy cân nhắc sử dụng LoRA thay thế.
Cách sử dụng
from diffusers import StableDiffusionPipeline
from peft import LoHaConfig, get_peft_model

config_unet = LoHaConfig(
    r=8,
    alpha=8,
    target_modules=[
        "to_k",
        "to_q",
        "to_v",
        "to_out.0",
        "proj_in",
        "proj_out",
    ],
    rank_dropout=0.0,
    module_dropout=0.0,
    use_effective_conv2d=True,
)

pipeline = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5")
pipeline.unet = get_peft_model(pipeline.unet, config_unet)
pipeline.unet.print_healthcheck()
Tổng quan về benchmark
API
LoHaConfig
lớp peft.LoHaConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falserank_pattern: Optional[dict] = <factory>alpha_pattern: Optional[dict] = <factory>r: int = 8alpha: int = 8rank_dropout: float = 0.0module_dropout: float = 0.0use_effective_conv2d: bool = Falsetarget_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = Nonemodules_to_save: Optional[list[str]] = None )
Tham số
- r (
int) — Rank của LoHa. - alpha (
int) — Tham số alpha cho việc scale LoHa. - rank_dropout (
float) — Xác suất dropout cho chiều rank trong quá trình huấn luyện. - module_dropout (
float) — Xác suất dropout để vô hiệu hóa các module LoHa trong quá trình huấn luyện. - use_effective_conv2d (
bool) — Sử dụng tham số phân rã hiệu quả cho Conv2d (và Conv1d) với ksize > 1 (“Proposition 3” từ bài báo FedPara). - target_modules (
Optional[Union[List[str], str]]) — Tên của các module cần áp dụng adapter. Nếu được chỉ định, chỉ các module có tên được chỉ định sẽ được thay thế. Khi truyền một chuỗi, một phép khớp regex sẽ được thực hiện. Khi truyền một danh sách các chuỗi, một phép khớp chính xác sẽ được thực hiện hoặc kiểm tra xem tên của module có kết thúc bằng bất kỳ chuỗi nào được truyền hay không. Nếu được chỉ định là ‘all-linear’, thì tất cả các module linear/Conv1D sẽ được chọn, ngoại trừ lớp output. Nếu không được chỉ định, các module sẽ được chọn theo kiến trúc của model. Nếu kiến trúc không được biết đến, một lỗi sẽ được ném ra — trong trường hợp này, bạn nên chỉ định các module đích một cách thủ công. - exclude_modules (
Optional[Union[List[str], str]]) — Tên của các module không áp dụng adapter. Khi truyền một chuỗi, một phép khớp regex sẽ được thực hiện. Khi truyền một danh sách các chuỗi, một phép khớp chính xác sẽ được thực hiện hoặc kiểm tra xem tên của module có kết thúc bằng bất kỳ chuỗi nào được truyền vào hay không. - init_weights (
bool) — Có thực hiện khởi tạo trọng số của adapter hay không. Mặc định làTrue, việc truyềnFalsekhông được khuyến khích. - layers_to_transform (
Union[List[int], int]) — Các chỉ số lớp cần biến đổi. Nếu truyền vào một danh sách các số nguyên, adapter sẽ được áp dụng cho các chỉ số lớp được chỉ định trong danh sách này. Nếu truyền vào một số nguyên duy nhất, các phép biến đổi sẽ được áp dụng cho lớp tại chỉ số này. - layers_pattern (
Optional[Union[List[str], str]]) — Tên mẫu lớp, chỉ được sử dụng nếulayers_to_transformkhácNone. Giá trị này cần nhắm đếnnn.ModuleListcủa mô hình, thường được gọi là'layers'hoặc'h'. - rank_pattern (
dict) — Bản ánh xạ từ tên lớp hoặc biểu thức chính quy đến các rank khác với rank mặc định được chỉ định bởir. Ví dụ,{'^model.decoder.layers.0.encoder_attn.k_proj': 16}. - alpha_pattern (
dict) — Bản ánh xạ từ tên lớp hoặc biểu thức chính quy đến các alpha khác với alpha mặc định được chỉ định bởialpha. Ví dụ,{'^model.decoder.layers.0.encoder_attn.k_proj': 16}. - modules_to_save (
Optional[List[str]]) — Danh sách các module ngoài các lớp adapter cần được đặt là có thể huấn luyện và lưu trong checkpoint cuối cùng.
Đây là lớp cấu hình để lưu trữ cấu hình của một LoHaModel.
LoHaModel
lớp peft.LoHaModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Tham số
- model (
torch.nn.Module) — Mô hình mà các lớp adapter tuner sẽ được gắn vào. - config (LoHaConfig) — Cấu hình của mô hình LoHa.
- adapter_name (
str) — Tên của adapter, mặc định là"default". - low_cpu_mem_usage (
bool,optional, mặc định làFalse) — Tạo trọng số adapter rỗng trên thiết bị meta. Hữu ích để tăng tốc quá trình tải.
Trả về
torch.nn.Module
Mô hình LoHa.
Tạo mô hình Low-Rank Hadamard Product từ một mô hình được huấn luyện trước. Phương pháp này được mô tả một phần tại https://huggingface.co/papers/2108.06098 Bản triển khai hiện tại vay mượn phần lớn từ https://github.com/KohakuBlueleaf/LyCORIS/blob/eb460098187f752a5d66406d3affade6f0a07ece/lycoris/modules/loha.py
Ví dụ:
>>> from diffusers import StableDiffusionPipeline
>>> from peft import LoHaModel, LoHaConfig

>>> config_te = LoHaConfig(
...     r=8,
...     lora_alpha=32,
...     target_modules=["k_proj", "q_proj", "v_proj", "out_proj", "fc1", "fc2"],
...     rank_dropout=0.0,
...     module_dropout=0.0,
...     init_weights=True,
... )
>>> config_unet = LoHaConfig(
...     r=8,
...     lora_alpha=32,
...     target_modules=[
...         "proj_in",
...         "proj_out",
...         "to_k",
...         "to_q",
...         "to_v",
...         "to_out.0",
...         "ff.net.0.proj",
...         "ff.net.2",
...     ],
...     rank_dropout=0.0,
...     module_dropout=0.0,
...     init_weights=True,
...     use_effective_conv2d=True,
... )

>>> model = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5")
>>> model.text_encoder = LoHaModel(model.text_encoder, config_te, "default")
>>> model.unet = LoHaModel(model.unet, config_unet, "default")
Thuộc tính:
- model (
~torch.nn.Module) — Mô hình cần được thích ứng. - peft_config (LoHaConfig): Cấu hình của mô hình LoHa.